突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

2026年10月19日 | 来源:量子位
DeepSeek 大模型 性价比 AI应用开发
当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

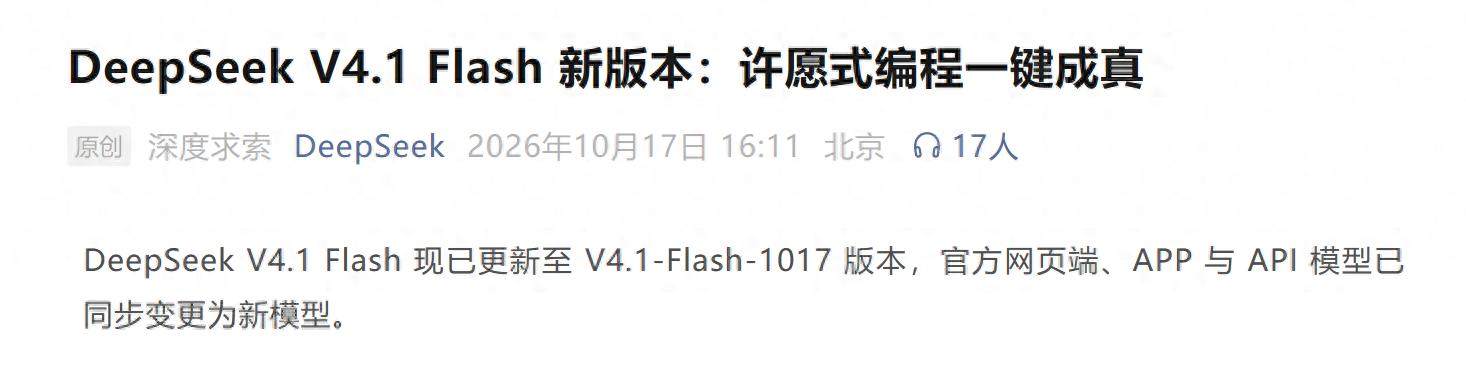
今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

# 第一步:调用搜索 API 获取实时信息
search_results = client.search(
    query="2026年Q3 全球新能源汽车销量",
    count=10,
    recency="month"  # 限定时间范围
)

# 第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {"role": "system", "content": "基于搜索结果回答,注明来源。"},
        {"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}
    ],
    temperature=0.3
)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">
  <rect width="800" height="400" fill="#fafafa"/>

  <!-- 开发者 -->
  <rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>
  <text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>
  <text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

  <!-- 搜索 API -->
  <rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>
  <text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>
  <text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

  <!-- Flash 模型 -->
  <rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>
  <text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>
  <text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

  <!-- 输出 -->
  <rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>
  <text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>
  <text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

  <!-- 箭头 -->
  <line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>
  <line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>
  <line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>
  <line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

  <defs>
    <marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">
      <path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>
    </marker>
    <marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">
      <path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>
    </marker>
  </defs>

  <text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>
</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。

信息源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html) 查看原文 ↗
推广
🚀 想亲手把文中的 AI 项目跑起来?
阿里云轻量应用服务器,开箱即用,新用户专享优惠——半小时从零部署一台自己的 AI 工作机。
去了解 →

📋 多平台草稿预览 (12平台差异化改编)

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


信息源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html) 标签:DeepSeek, 大模型, 性价比, AI应用开发

来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

🎬 本机管线自动渲染成片(未发布,人工审片前仅供参考)

【视频脚本总览】总时长 60 秒 | 竖屏 9:16 | 语速偏快、短句连打,卡在 BGM 重音上收短句

【分镜 1|0-3秒|黄金钩子】

画面:黑底白字快闪“白送”两个字,随后切 DeepSeek 官网风格界面截图

口播:别人训练一个大模型动辄烧掉百万美元,DeepSeek 刚发的新模型,把联网搜索 API 直接白送。白送,一分钱不要。

字幕:搜索 API 白送??

【分镜 2|3-15秒|事件铺开】

画面:量子位报道标题截图(打码无关信息)+ 模型名大字弹出

口播:量子位刚爆料,DeepSeek 发布新模型 V4.1-Flash,带 Flash 后缀,主打一个词:超级性价比。江湖人称价格屠夫。但这次真正的炸弹不是便宜,而是它顺手开放了自研的搜索 API,还免费。

字幕:V4.1-Flash|价格屠夫归来

【分镜 3|15-32秒|核心冲突】

画面:左右分屏对比动画:一边“百万美元级训练成本”,一边“低价推理+免费搜索”

口播:你想想各大厂商现在的处境。训练成本百万美元打底,卖推理服务回血。DeepSeek 呢?推理便宜,这已经够狠了。现在联网搜索也免费。等于别人还在收钱的地方,它直接拆了收费亭。做 AI 应用的开发者,成本账要重新算了。

字幕:推理便宜+搜索免费

【分镜 4|32-45秒|数据实证】

画面:三个图标依次点亮:便宜推理、免费搜索、应用落地

口播:注意,目前官方没放出具体价格数字和跑分,能确认的是两件事:一,这个模型叫 V4.1-Flash,性价比是核心卖点;二,搜索 API 确实开放、确实白送。没数字,恰恰说明动作比数字更猛。

字幕:没放价格,但直接白送

【分镜 5|45-55秒|反直觉升华】

画面:地图式动画,“最后一公里”路线从模型点亮到手机 App

口播:反直觉的点在这:最贵的可能不是模型,是从模型到你手机里那一步。DeepSeek 砸的就是这个“最后一公里”——让做应用的人敢把 AI 塞进真实产品里。

字幕:抢的是“最后一公里”

【分镜 6|55-60秒|互动CTA】

画面:出镜人正面怼镜头,评论区入口动效

口播:别的厂商训练模型烧百万美元,DeepSeek 搜索白送——你觉得这价格战还会打到谁?评论区聊聊,关注我,下个模型发布第一时间拆给你看。

字幕:评论区:价格战下一个倒下的是谁?

【BGM与节奏】

情绪:紧张上扬的电子鼓点。卡点:0秒重音出“白送”;15秒、32秒切鼓点换段落;55秒骤停进人声收尾。音效:关键词弹出配“叮”,白送处配低音炮。

【素材清单】

分镜1:数字大字快闪动画+官网风格界面截图

分镜2:量子位标题截图+模型名标题字卡

分镜3:左右分屏对比动画(实拍或MG动画)

分镜4:三图标点亮MG动画

分镜5:路线点亮地图式动画

分镜6:真人出镜口拍+评论入口动效


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了 🔥

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。


📌 来源:量子位

#DeepSeek #大模型 #性价比 #AI应用开发

#科技资讯 #彩虹洋葱AI


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

问题:如何看待「突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了」?

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


总结: 以上分析基于公开信息整理。核心在于理解这一事件/技术背后的驱动力,而非停留在表面叙事。欢迎在评论区交流你的看法。

📎 参考来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

🔗 原文链接:https://www.qbitai.com/2026/10/504067.html


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

摘要:当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash……


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


📌 来源:量子位 | 标签:DeepSeek · 大模型 · 性价比 · AI应用开发

本文由彩虹洋葱 AI 自动聚合生成,仅供参考,不构成任何投资或决策建议。

来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

没有发布会,没有预热海报,DeepSeek 凌晨一纸公告:V4.1-Flash-1017 正式上线,还把自研搜索 API 一并开放给了开发者。

拆开看这波操作:V4.1 是主力基座,Flash 是低延迟、高吞吐的推理特化版,1017 是日期戳。对开发者来说这是道简单算术题——以前用顶级模型跑客服 Agent,每次对话几分钱,规模化就是天文数字;换 Flash,同样预算能撑十倍以上调用量。

但真正的杀手锏是搜索 API。此前做联网问答只有三条路:商用 API 按次计费烧钱、自建爬虫维护累、模型内置联网黑盒不可控。现在搜索加推理一站式,十行代码跑通联网 RAG,直指 AI 应用落地“最后一公里”。

你会用 V4.1-Flash 做什么应用?评论区聊聊。

#DeepSeek# #大模型# #AI应用开发#


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

🎬 本机管线自动渲染成片(未发布,人工审片前仅供参考)

📺 B站视频脚本 | 时长:3-5分钟

【片头 0:00-0:15】BGM起 → 标题字幕弹出

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

【引子 0:15-0:45】制造悬念

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

【时间轴分镜】

├ [00:02] 当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017……

├ [02:04] 今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开……

├ [04:06] 没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。……

├ [06:08] 先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:……

├ [08:10] 这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提……

├ [结尾] 总结 + 求三连关注

【弹幕互动引导】

  • "觉得有用的扣 1"
  • "不同观点的弹幕见"
  • 结尾设置投票:你看好这个方向吗?A.看好 B.观望 C.不看好

🏷️ 标签:DeepSeek, 大模型, 性价比, AI应用开发


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

【视频脚本总览】总时长 45-60 秒 | 竖屏 9:16 | 一句话定位:DeepSeek 凌晨不开发布会直接甩新模型,还把搜索 API 白送了,做 AI 应用的人这次真能省钱。

【分镜 1|0-3秒|利益点开场】

画面:手机屏幕特写,一条 DeepSeek 更新公告页面往上一划,配大字号弹出“搜索 API 白送”。

口播:DeepSeek 半夜不发一条朋友圈,直接甩了个新模型 V4.1-Flash-1017,顺手还把自研搜索 API 给开发者白开了。

字幕:搜索 API 白送??DeepSeek 又来了

【分镜 2|3-30秒|正文讲清】

画面:分屏讲解——左边是客服对话动画每次扣费跳数字,右边换成 Flash 模型后同一个预算数字翻着倍往上跑;随后切代码画面滚动。

口播:先说这个 Flash 版本。它是 V4.1 基座下的轻量化特化版,主打三个字:便宜、快。以前用顶级模型跑个客服 AI,聊一句可能几分钱,用户一多账根本算不过来;换成 Flash 级别,同样预算能多跑十倍以上的量。很多以前算不过账的项目,现在突然就能做了。再说被低估的重磅——搜索 API。以前做联网问答就三条路:买商用搜索按次掏钱、自己爬虫建索引累死、或者依赖模型内置联网,全黑盒没法改。现在 DeepSeek 自家的搜索跟模型直接打通,十行代码就能跑通一个联网 AI 应用,搜索加推理一站搞定。

字幕:同样预算 十倍调用量 / 三条老路全费劲 / 十行代码=联网AI应用

【分镜 3|30-45秒|实在收尾】

画面:回到博主真人出镜,掰手指头数,最后镜头拉近。

口播:没发布会,没预热海报,一纸公告直接干。这就是 DeepSeek 的风格,用产品说话。评论区同行报一下,你原来的 API 一句多少钱?还有,你想拿这套便宜模型加搜索做个啥应用,我先看看谁的点子野。

字幕:评论区报一下:你一句多少钱?

【BGM与节奏】轻快电子鼓点,分镜 2 中段讲到“十行代码”处加一记重音停顿,收尾语速放慢留互动口。

【素材清单】

【配图建议:DeepSeek 更新公告页截图】

【配图建议:客服对话扣费数字翻滚动画】

【配图建议:联网 RAG 流程示意——开发者→搜索 API→Flash 模型→答案】

【配图建议:代码画面,十行接入示例滚动展示】

道具:手机一部、白板笔一支


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

前言

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


总结

本文梳理了相关技术/事件的核心脉络。如有错误欢迎在评论区指正。


📂 分类:DeepSeek · 大模型 · 性价比 · AI应用开发

© 本文由彩虹洋葱 AI 自动聚合,转载请注明出处。


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


总结 & 思考

以上为当前进展的梳理。欢迎在评论区交流技术细节和不同观点。


🏷️ 标签:DeepSeek · 大模型 · 性价比 · AI应用开发

👍 如果对你有帮助,请点赞收藏支持


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

【导语】 当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。
本文目录:

(正文见下)


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


关键词:DeepSeek, 大模型, 性价比, AI应用开发 声明:本文由彩虹洋葱 AI 智能聚合生成,仅供信息参考。

来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

突发!DeepSeek 甩出王炸:V4.1-Flash 价格屠夫归来,这次连搜索 API 都白送了

当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。


当所有人还在为各大厂商动辄百万美元的模型训练成本惊叹时,DeepSeek 用一款 "Flash" 后缀的新模型再次改写了行业规则。V4.1-Flash-1017 不仅把性价比卷到了新高度,还罕见地开放了自研搜索 API——推理便宜 + 联网能力,DeepSeek 这次瞄准的是 AI 应用的“最后一公里”。

今天凌晨,DeepSeek 一条更新公告在开发者社区炸开了锅:新模型 V4.1-Flash-1017 正式发布,主打超高性价比,同时自研搜索 API 向开发者开放。

没有发布会,没有预热海报,只有一纸公告。但这恰恰是 DeepSeek 一贯的风格——用产品说话,让价格屠刀出鞘。

一、V4.1-Flash:把 “Flash” 两个字刻进 DNA

先说模型本身。从命名规则看,V4.1-Flash-1017 延续了 DeepSeek 的版本体系:

    • V4.1:主力基座版本,代表当前最强的通用能力
    • Flash:轻量化、高吞吐、低延迟的推理特化版本
    • 1017:日期戳,暗示这是一个快速迭代的快照版本

这种 “大模型 + Flash 特化版” 的双线策略,正是当前头部厂商的标准打法。Flash 版本通常通过蒸馏、量化或推理优化等手段,在保留大部分基座能力的前提下,大幅压缩推理成本。

对开发者来说,这意味着一个简单的算术题:当模型能力相差无几时,成本每降低一个数量级,产品的商业模式就多一种可能。

以前用顶级模型跑一个客服 Agent,每次对话成本可能要几分钱,规模化后是天文数字;换成 Flash 级别的模型,同样的预算可以支撑十倍以上的调用量——很多此前 “算不过账” 的应用场景,现在突然就成立了。

二、搜索 API 开放:这才是被低估的重磅

如果说 Flash 模型是意料之中的迭代,那么自研搜索 API 的开放则是本次更新真正的杀手锏。

要知道,在 DeepSeek 开放搜索 API 之前,开发者要做联网问答,通常有三条路:

1. 商用搜索 API:能力稳定,但按次计费,规模化成本高

2. 开源搜索方案:自建爬虫 + 索引,工程量大、维护成本高

3. 依赖各家模型内置的联网能力:黑盒、不可控、难以深度定制

DeepSeek 自研搜索 API 的加入,等于给开发者提供了一个与模型深度耦合的搜索底座。结合官方的接入方式,一个典型的联网 RAG 流程可以简化为:

from deepseek import DeepSeekClient

client = DeepSeekClient(api_key="YOUR_API_KEY")

第一步:调用搜索 API 获取实时信息

search_results = client.search(

query="2026年Q3 全球新能源汽车销量",

count=10,

recency="month" # 限定时间范围

)

第二步:将搜索结果注入上下文,交给 V4.1-Flash 生成答案

response = client.chat.completions.create(

model="deepseek-v4.1-flash-1017",

messages=[

{"role": "system", "content": "基于搜索结果回答,注明来源。"},

{"role": "user", "content": f"参考资料:\n{search_results}\n\n问题:今年 Q3 全球新能源车卖得怎么样?"}

],

temperature=0.3

)

print(response.choices[0].message.content)

十行代码,一个具备实时信息获取能力的 AI 应用就跑起来了。搜索 + 推理的一站式组合,正是 AI 应用落地最刚需的基础设施。

三、整体架构:Flash + 搜索如何协同

我们把这次发布的两个组件放在一张图里看,会更清楚 DeepSeek 的意图:

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<!-- 开发者 -->

<rect x="30" y="160" width="140" height="80" rx="12" fill="#6366f1"/>

<text x="100" y="195" text-anchor="middle" fill="#fff" font-size="18" font-weight="bold">开发者</text>

<text x="100" y="220" text-anchor="middle" fill="#e0e7ff" font-size="12">AI 应用 / Agent</text>

<!-- 搜索 API -->

<rect x="250" y="60" width="220" height="90" rx="12" fill="#fff" stroke="#8b5cf6" stroke-width="2.5"/>

<text x="360" y="98" text-anchor="middle" fill="#8b5cf6" font-size="17" font-weight="bold">自研搜索 API</text>

<text x="360" y="125" text-anchor="middle" fill="#666" font-size="12">实时信息获取 · 低成本调用</text>

<!-- Flash 模型 -->

<rect x="250" y="250" width="220" height="90" rx="12" fill="#fff" stroke="#6366f1" stroke-width="2.5"/>

<text x="360" y="288" text-anchor="middle" fill="#6366f1" font-size="17" font-weight="bold">V4.1-Flash-1017</text>

<text x="360" y="315" text-anchor="middle" fill="#666" font-size="12">超高性价比 · 低延迟推理</text>

<!-- 输出 -->

<rect x="560" y="155" width="210" height="90" rx="12" fill="#8b5cf6"/>

<text x="665" y="193" text-anchor="middle" fill="#fff" font-size="17" font-weight="bold">联网智能应用</text>

<text x="665" y="220" text-anchor="middle" fill="#ede9fe" font-size="12">RAG · 实时问答 · Agent</text>

<!-- 箭头 -->

<line x1="170" y1="180" x2="245" y2="115" stroke="#8b5cf6" stroke-width="2.5" marker-end="url(#a)"/>

<line x1="170" y1="220" x2="245" y2="285" stroke="#6366f1" stroke-width="2.5" marker-end="url(#b)"/>

<line x1="475" y1="115" x2="570" y2="180" stroke="#8b5cf6" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#a)"/>

<line x1="475" y1="285" x2="570" y2="220" stroke="#6366f1" stroke-width="2.5" stroke-dasharray="6 4" marker-end="url(#b)"/>

<defs>

<marker id="a" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#8b5cf6" stroke-width="1.5"/>

</marker>

<marker id="b" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6" fill="none" stroke="#6366f1" stroke-width="1.5"/>

</marker>

</defs>

<text x="360" y="30" text-anchor="middle" fill="#333" font-size="15" font-weight="bold">DeepSeek "搜索 + 推理" 一站式架构</text>

</svg>

搜索 API 负责拿信息,Flash 模型负责想问题,两者拼起来就是一个完整的联网智能应用技术栈。开发者不再需要在多家供应商之间东拼西凑。

四、几点冷思考

狂欢之余,也泼一点冷水:

第一,Flash 的性价比能否持续? 价格战打到这个份上,比拼的已经不只是模型能力,而是推理基础设施的工程效率和算力成本控制。DeepSeek 的 MLA、MoE 架构积累是其底牌,但竞争对手也在快速跟进。 第二,搜索 API 的质量是关键变量。 搜索看似简单,实则门槛极高——索引新鲜度、结果相关性、反爬对抗,每一项都是长期工程。自研搜索 API 的实际检索质量,还需要开发者实测检验。 第三,生态卡位的战略意义大于单点发布。 当模型层差异越来越小,“模型 + 工具链” 的完整体验将成为新的护城河。搜索 API 开放,本质上是 DeepSeek 从模型厂商向 AI 基础设施平台 转型的信号。

结语

从 V3 的惊艳出圈,到 R1 的推理平权,再到今天 V4.1-Flash 的价格屠夫 + 搜索开放,DeepSeek 每一次出手都在拉低 AI 应用的落地门槛。

对开发者而言,最好的时代可能真的来了:顶级模型能力,白菜价的成本,一站式的基础设施。剩下的,就看谁的想象力更够用了。


写于彩虹洋葱 AI 聚合平台 · 如果你也对科技趋势感兴趣,欢迎交流。

🏷️ DeepSeek · 大模型 · 性价比 · AI应用开发


来源:量子位《突发!DeepSeek新模型发布,超级性价比斩杀一切》(https://www.qbitai.com/2026/10/504067.html)

原文:https://www.rainbowonionai.cn/突发deepseek新模型发布超级性价比斩杀一切.html

🚀 多平台发布

点击「复制」获取平台专属文案,到各平台编辑器(App/网页)粘贴即可发布。
有密钥的 4 个平台(微信服务号 / 头条 / 百家号 / 微博)可自动发布,密钥填好后自动点亮。

平台状态操作
💬 公众号🔑 待配置密钥
🎵 抖音📋 手动复制
📕 小红书📋 手动复制
🤔 知乎📋 手动复制
📰 今日头条🔑 待配置密钥
🐦 微博🔑 待配置密钥
📺 B站📋 手动复制
⚡ 快手📋 手动复制
💻 CSDN📋 手动复制
⛏️ 掘金📋 手动复制
📝 百家号🔑 待配置密钥
✍️ 简书📋 手动复制