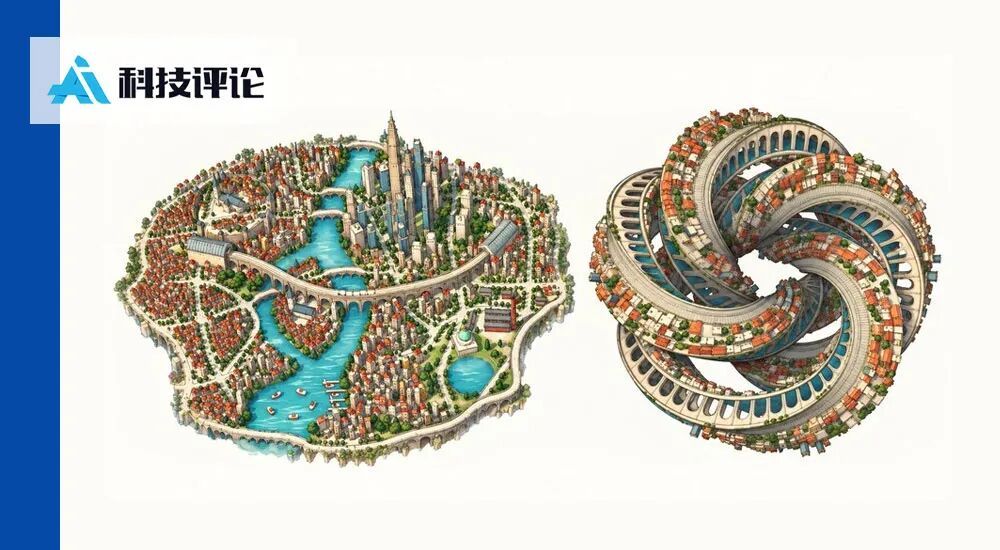
“我们错了。”当一位深耕可解释性多年的研究者公开推翻自己乃至整个领域的核心前提时,值得所有人停下来听一听。Nick Cammarata 的这篇万字长文,正在 AI 圈掀起一场关于“黑箱”叙事的集体反思。
一篇长文,推翻一个时代的共识

过去十年,“神经网络是黑箱”几乎是 AI 领域最根深蒂固的共识。从学术论文到媒体报章,从监管讨论到公众认知,这句话被重复了千万次,以至于很少有人再追问:它到底是事实,还是我们懒惰的借口?
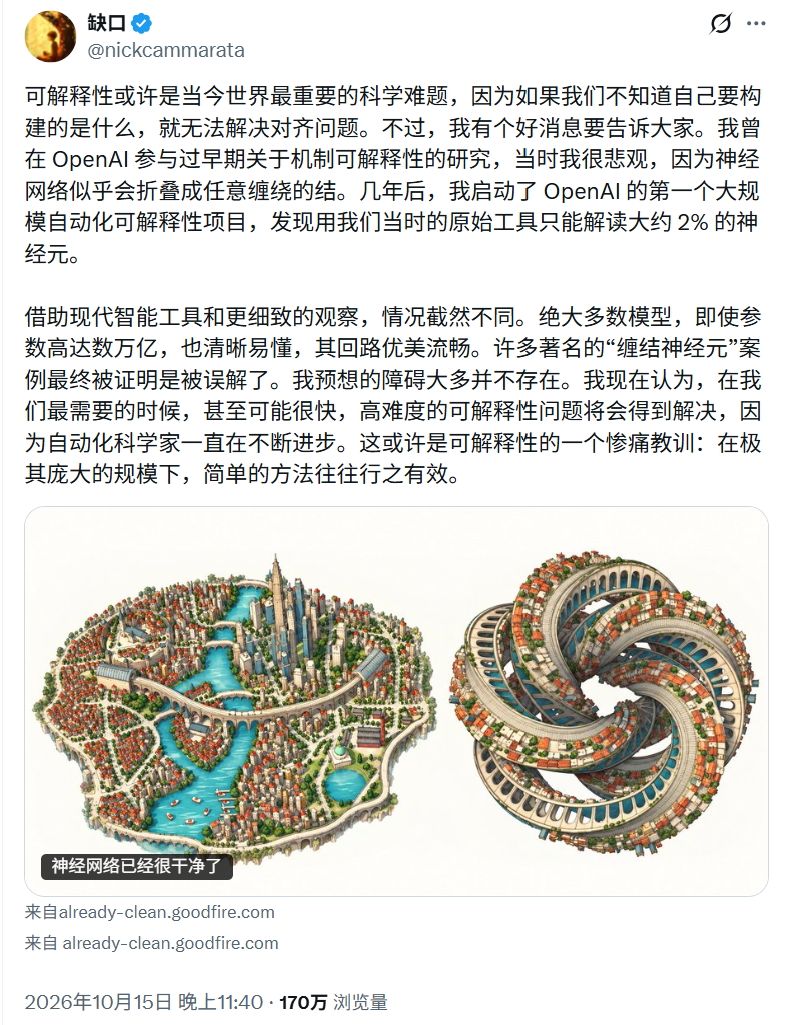
最近,可解释性研究者 Nick Cammarata 发表了一篇万字长文,直接对这个共识宣战。他的核心论点掷地有声:AI 不是黑箱,恰恰相反,约 99% 的神经元是清晰可见、可以被理解的。真正的瓶颈不在于神经网络本身有多神秘,而在于我们解读它的工具和方法论严重落后。
这一观点的颠覆性在于:它把问题的责任从“模型”转移到了“我们”。黑箱不在机器里,而在人类自己给自己设置的认知舒适区里。
为什么说 99% 的神经元“可见”?
Cammarata 的论证逻辑可以拆解为三层:

# 一个极简的稀疏自编码器示意:
# 把纠缠的神经元激活分解为稀疏、可解释的特征
import torch
import torch.nn as nn

class SparseAutoencoder(nn.Module):
    def __init__(self, n_inputs, n_features, sparsity_coef=1e-3):
        super().__init__()
        self.encoder = nn.Linear(n_inputs, n_features)
        self.decoder = nn.Linear(n_features, n_inputs)
        self.sparsity_coef = sparsity_coef

    def forward(self, x):
        # 编码:将高维纠缠激活映射到更大但稀疏的特征空间
        features = torch.relu(self.encoder(x))
        # L1 惩罚逼迫特征稀疏化 —— 每个特征只对少数概念激活
        recon = self.decoder(features)
        loss = ((recon - x) ** 2).mean() \
             + self.sparsity_coef * features.abs().mean()
        return recon, features, loss

这段代码的哲学很简单:用一个更宽的稀疏空间,换取语义的纯净度。 当特征足够稀疏时,“一个特征 = 一个概念”的假设开始成立,解释工作才真正成为可能。
可解释性的技术版图:我们在哪里?
为了直观理解当前可解释性研究的层次,可以看这张示意图:
为什么要纠结“是不是黑箱”?
有人会说:管它黑箱白箱,能用就行。但 Cammarata 认为,这种态度的代价是巨大的:
对齐与安全。 如果我们连模型内部在“想”什么都说不清,如何保证一个千亿参数的系统不会欺骗我们、不会在训练中学会隐藏目标?可解释性是对齐研究的技术底座,只有打开引擎盖,才能检查发动机有没有被装了“后门”。 监管与信任。 全球 AI 立法浪潮中,“可解释性”反复出现。如果“黑箱”是一个可被推翻的错误前提,那么监管框架的很多假设都需要重写,我们完全可以要求模型给出机制层面的解释,而不是仅仅接受“它就是说不清”。 科学地位。 深度学习至今仍被讥讽为“炼金术”。如果 99% 的内部表征是可读的,那么 AI 研究就有机会从经验工程走向真正的科学:有假设、有验证、有理论。争议与冷思考
当然,这篇长文也招致了不少质疑。批评者的主要反驳点包括:
其一,“可见”与“可理解”之间的鸿沟可能远比想象中深。 知道每个特征是什么,不代表能解释模型为什么输出这个答案,正如认识每一个单词不等于读懂一首诗。
其二,稀疏自编码器提取的特征是否“真实”存在争议。 它们可能只是人类喜欢的分解方式,而模型真实的计算结构未必如此切分。存在“过度拟人化解释”的风险。
其三,99% 这个数字本身带有修辞色彩。 神经元层面的可见性,不等于行为层面、决策层面的可解释性。剩下的 1% 也许恰恰是最关键的决策路径。
但即便如此,Cammarata 的观点依然有价值:它把一个被说烂了的结论重新变成了可以被辩论的问题。科学进步往往始于有人站出来说“大家都错了”。
写在最后
“黑箱”这三个字,过去十年为整个行业提供了一种廉价的免责:我们不理解它,因为它不可理解。而 Cammarata 的长文撕开了这层遮羞布,不可理解的从来不是模型,而是我们尚未建好的工具和尚未付出的努力。
也许再过十年回头看,2020 年代的 AI 可解释性研究会像今天的基因测序一样:曾经被认为不可能读懂的密码本,最终变成了标准化的读数仪。黑箱从未存在,存在的只是还没点亮的灯。