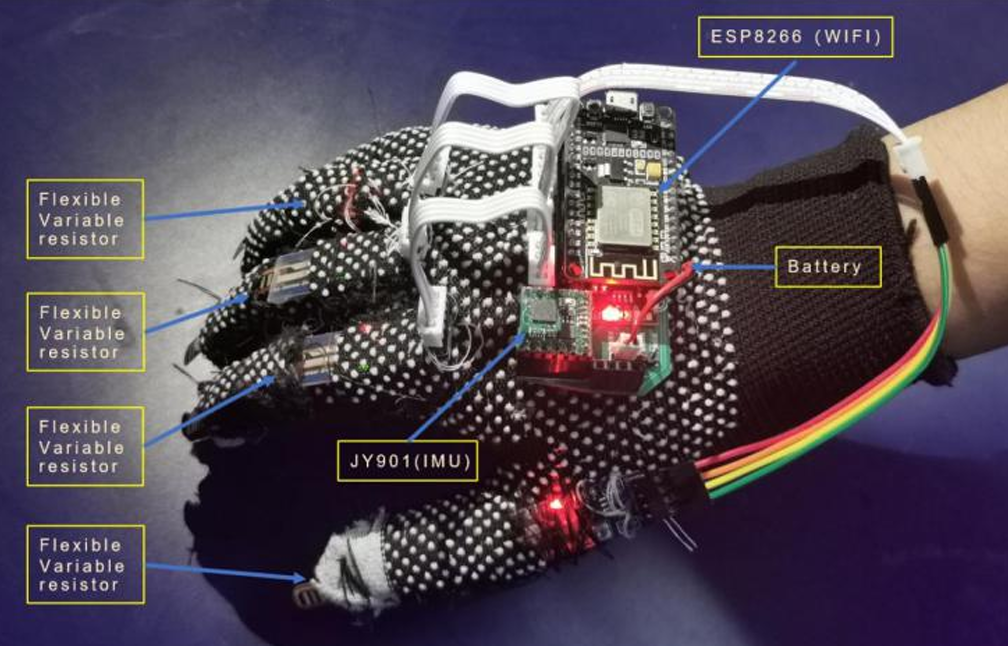
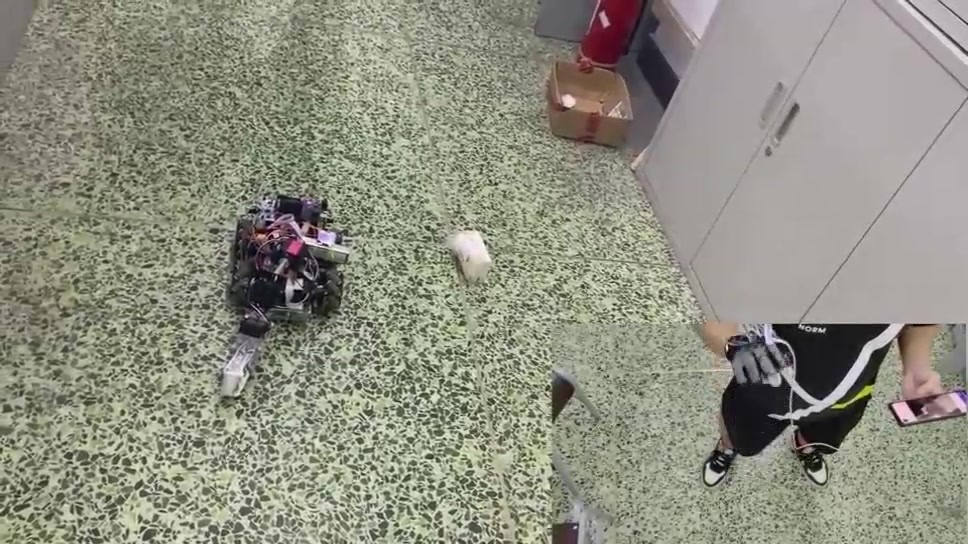
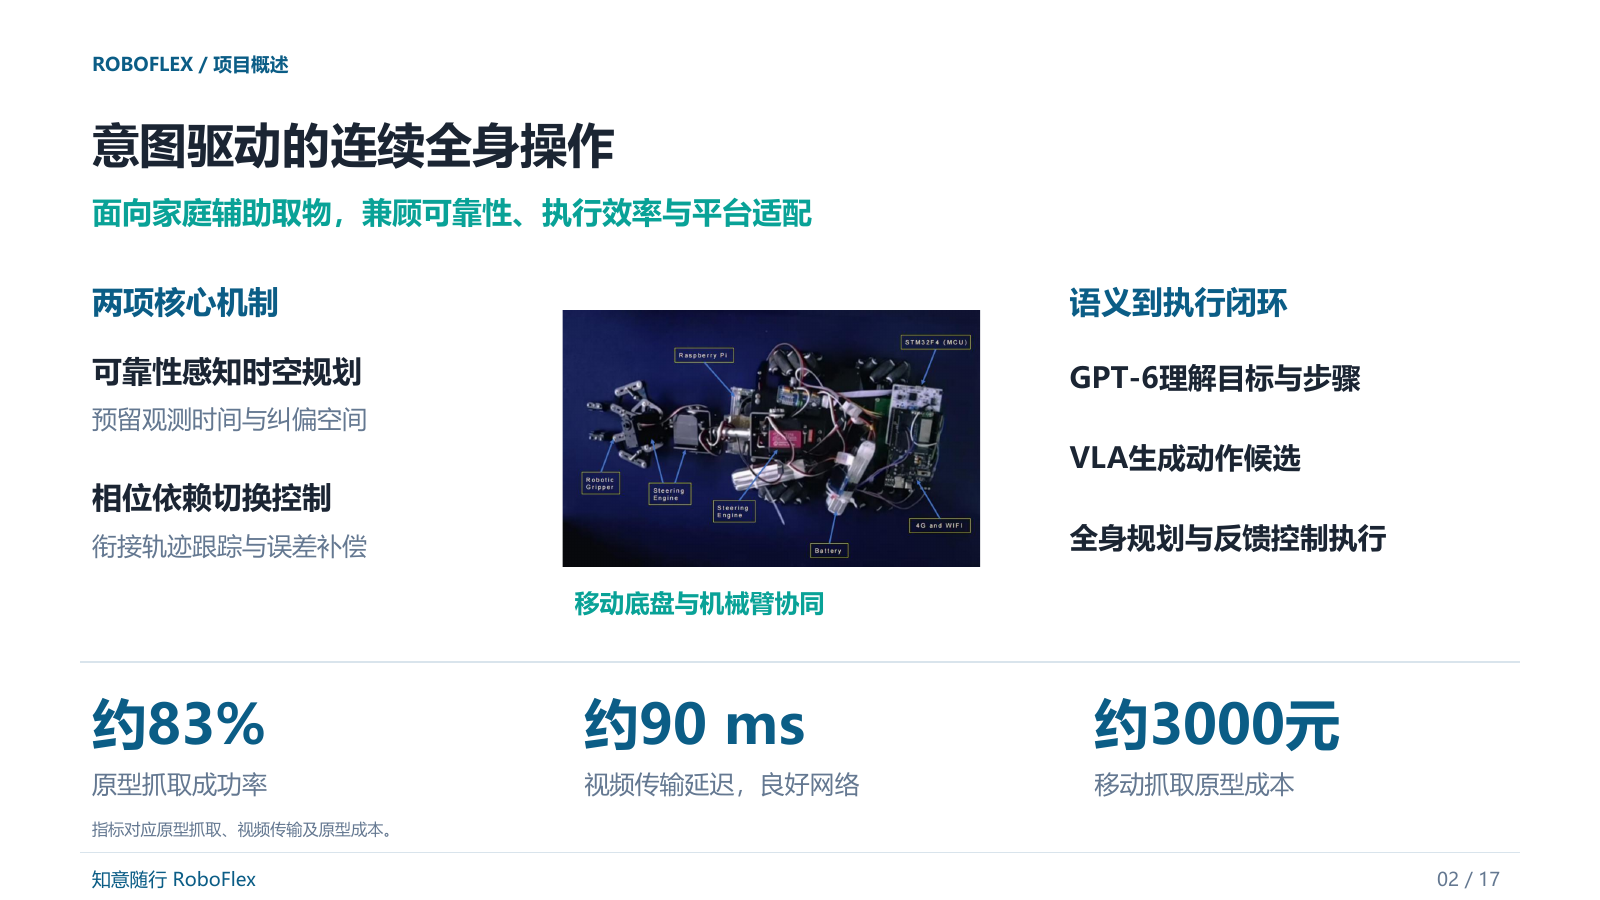
一位高位截瘫患者想喝水,他不需要按下任何按钮,只需要看向桌上的杯子,几秒钟后,机器人缓缓移动过来,机械臂稳稳地将水杯递到他嘴边。这不是科幻电影,而是刚登上 GitHub Trending 的开源项目 RoboFlex 正在实现的事情。
近日,一个名为 RoboFlex 的项目悄然登上 GitHub Trending。这个由 txwang-tju 开源的系统,瞄准的是一个长期被技术圈忽视、却极具社会价值的方向:面向行动不便者的多模态意图理解机器人。它结合 GPT-6 级别的视觉理解能力,协调移动底盘与机械臂,完成从“理解人想要什么”到“把东西拿过来”的完整任务闭环。

一、为什么“意图理解”是助残机器人最难的一环?
工业机器人已经能以亚毫米精度完成焊接、装配,但走进家庭、服务行动不便者的机器人却迟迟没有大规模落地。核心瓶颈不在运动控制,而在于理解人“想要什么”。
传统交互方式存在明显缺陷:
- 语音控制:对发声障碍患者、语言表达能力受限的群体不友好
- 物理按钮/摇杆:对高位截瘫、渐冻症患者操作成本极高
- 固定指令集:无法应对开放环境中的长尾需求
RoboFlex 的解题思路是多模态融合:将视线(眼动/头部朝向)、手势、语音、上下文场景同时输入系统,由大模型进行意图推理。用户看向什么、手势指向哪里、当前场景里有什么物品,这些信号被融合后,由视觉-语言大模型输出结构化的任务指令。
# RoboFlex 意图融合的核心逻辑(示意)
class IntentFusion:
    def __init__(self, vlm, gaze_tracker, gesture_recognizer):
        self.vlm = vlm                    # GPT-6 视觉理解模块
        self.gaze = gaze_tracker          # 视线追踪
        self.gesture = gesture_recognizer # 手势识别

    def infer(self, frame, gaze_vector, hand_keypoints, history):
        # 1. 场景理解:识别视野内物体及其空间关系
        scene = self.vlm.describe_scene(frame)
        # 2. 注意力推断:视线落点对应的候选目标
        targets = self.gaze.map_to_objects(scene, gaze_vector)
        # 3. 手势消歧:结合手势确认意图
        intent = self.vlm.reason(
            prompt=f"场景: {scene}\n注视目标: {targets}\n"
                   f"手势: {self.gesture.decode(hand_keypoints)}\n"
                   f"历史交互: {history}\n用户想要什么?",
            output_schema={
                "action": "fetch|adjust|call_help",
                "target_object": str,
                "grasp_pose": [float] * 6,
            }
        )
        return intent
关键在于第 3 步:借助大模型的推理能力,系统不再依赖穷举式的规则匹配,而是能处理“我口渴”“把那个够不着的东西拿过来”这类模糊、开放的表达。

二、从“理解”到“执行”:底盘 + 机械臂的任务编排
意图理解只是第一步。RoboFlex 的系统架构是一个典型的感知-规划-执行分层设计:
<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">
  <defs>
    <marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">
      <path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>
    </marker>
  </defs>
  <!-- 多模态输入层 -->
  <rect x="30" y="40" width="200" height="320" rx="12" fill="#f5f3ff" stroke="#8b5cf6" stroke-width="2"/>
  <text x="130" y="70" text-anchor="middle" font-size="18" font-weight="bold" fill="#6366f1">多模态输入</text>
  <rect x="50" y="90" width="160" height="40" rx="6" fill="#8b5cf6" opacity="0.15"/>
  <text x="130" y="116" text-anchor="middle" font-size="14" fill="#4c1d95">视觉 / 摄像头</text>
  <rect x="50" y="145" width="160" height="40" rx="6" fill="#8b5cf6" opacity="0.15"/>
  <text x="130" y="171" text-anchor="middle" font-size="14" fill="#4c1d95">视线追踪</text>
  <rect x="50" y="200" width="160" height="40" rx="6" fill="#8b5cf6" opacity="0.15"/>
  <text x="130" y="226" text-anchor="middle" font-size="14" fill="#4c1d95">手势识别</text>
  <rect x="50" y="255" width="160" height="40" rx="6" fill="#8b5cf6" opacity="0.15"/>
  <text x="130" y="281" text-anchor="middle" font-size="14" fill="#4c1d95">语音信号</text>
  <!-- 意图理解层 -->
  <rect x="300" y="100" width="200" height="200" rx="12" fill="#eef2ff" stroke="#6366f1" stroke-width="2"/>
  <text x="400" y="135" text-anchor="middle" font-size="18" font-weight="bold" fill="#6366f1">意图理解中枢</text>
  <rect x="320" y="155" width="160" height="35" rx="6" fill="#6366f1" opacity="0.18"/>
  <text x="400" y="178" text-anchor="middle" font-size="13" fill="#312e81">GPT-6 视觉理解</text>
  <rect x="320" y="200" width="160" height="35" rx="6" fill="#6366f1" opacity="0.18"/>
  <text x="400" y="223" text-anchor="middle" font-size="13" fill="#312e81">多模态融合推理</text>
  <rect x="320" y="245" width="160" height="35" rx="6" fill="#6366f1" opacity="0.18"/>
  <text x="400" y="268" text-anchor="middle" font-size="13" fill="#312e81">任务序列生成</text>
  <!-- 执行层 -->
  <rect x="570" y="40" width="200" height="320" rx="12" fill="#f5f3ff" stroke="#8b5cf6" stroke-width="2"/>
  <text x="670" y="70" text-anchor="middle" font-size="18" font-weight="bold" fill="#6366f1">具身执行</text>
  <rect x="590" y="95" width="160" height="45" rx="6" fill="#8b5cf6" opacity="0.2"/>
  <text x="670" y="123" text-anchor="middle" font-size="14" fill="#4c1d95">移动底盘导航</text>
  <rect x="590" y="160" width="160" height="45" rx="6" fill="#8b5cf6" opacity="0.2"/>
  <text x="670" y="188" text-anchor="middle" font-size="14" fill="#4c1d95">机械臂抓取规划</text>
  <rect x="590" y="225" width="160" height="45" rx="6" fill="#8b5cf6" opacity="0.2"/>
  <text x="670" y="253" text-anchor="middle" font-size="14" fill="#4c1d95">任务反馈闭环</text>
  <rect x="590" y="290" width="160" height="45" rx="6" fill="#8b5cf6" opacity="0.2"/>
  <text x="670" y="318" text-anchor="middle" font-size="14" fill="#4c1d95">安全监控</text>
  <!-- 箭头 -->
  <line x1="235" y1="200" x2="292" y2="200" stroke="#6366f1" stroke-width="2.5" marker-end="url(#arrow)"/>
  <line x1="505" y1="200" x2="562" y2="200" stroke="#6366f1" stroke-width="2.5" marker-end="url(#arrow)"/>
</svg>
整个流程可以拆解为一个任务序列:感知场景 → 推断意图 → 生成任务链(导航到目标附近 → 视觉伺服定位 → 抓取 → 递送)。其中“递送到手边”这一步尤为关键,对行动不便者来说,机器人把水杯放在桌上和递到手里,是完全不同的两种体验。这要求系统对人的姿态、手部位置有持续的感知,也体现了具身智能“以人为中心”的设计哲学。
值得注意的是“反馈闭环”环节:抓取失败、物体滑落、用户改变主意——这些现实中的扰动都需要系统能够实时调整任务序列,而不是一条道走到黑。
三、GPT-6 级视觉理解:具身智能的“大脑升级”

RoboFlex 选用 GPT-6 级别的大模型做视觉理解,反映了具身智能领域的一个明确趋势:机器人正在从“专用小模型堆叠”走向“通用大模型驱动”。
过去,机器人看懂一个场景需要目标检测、实例分割、关系推理等多个独立模型串联,每个环节的误差会层层放大。而现在,一个多模态大模型可以端到端地完成“看懂 + 推理 + 规划”,泛化能力也远超封闭指令集,用户家里出现一件训练时没见过的物品,大模型依然能基于常识理解“这是什么、该怎么拿”。
当然,这条路也有隐忧:大模型的推理延迟(通常在数百毫秒到秒级)对实时机器人控制是挑战,因此 RoboFlex 采用分层架构,大模型负责慢速的意图推理与任务规划,底层运动控制仍由实时系统承担。这也是当前具身智能的主流工程范式,“大脑”可以慢,“小脑”必须快。
四、技术之外:为什么这个方向值得更多开发者投入?
全球有超过 10 亿残障人士,中国肢体残疾人数超过 2400 万。护理人力短缺正在成为一个全球性问题,而助残机器人可能是 AI 技术社会价值最直接的落点之一。
相比追逐人形机器人的宏大叙事,RoboFlex 这样的项目更务实:不追求形态的仿人,而是用“移动底盘 + 机械臂”这个成本可控的组合,解决“取物递送”这一高频刚需。它开源的另一个意义在于降低了准入门槛,让高校实验室、创客团队甚至个人开发者都能在这个基础上做二次开发与本地化适配。
技术向善,不该只是一句口号。当 AI 的能力从“生成一篇文案”延伸到“递给一位患者一杯水”,具身智能才算真正触摸到了它存在的意义。