iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

2026年10月14日 | 来源:量子位
端侧大模型 多模态 开源
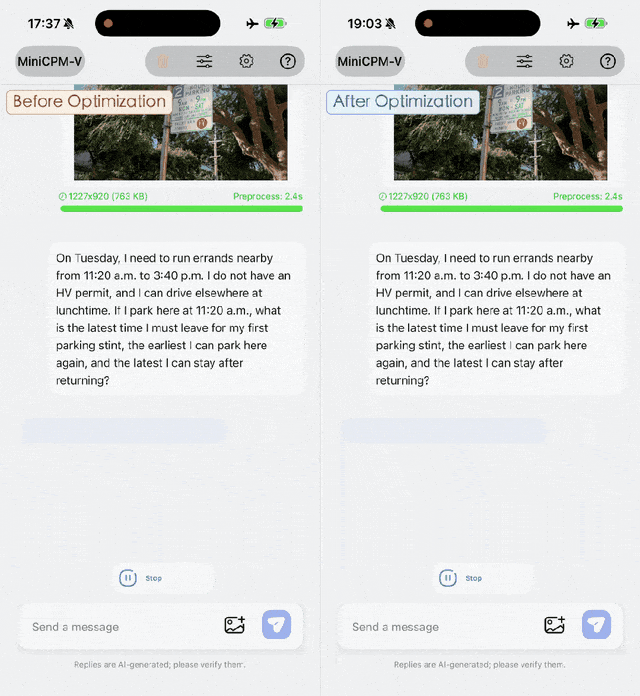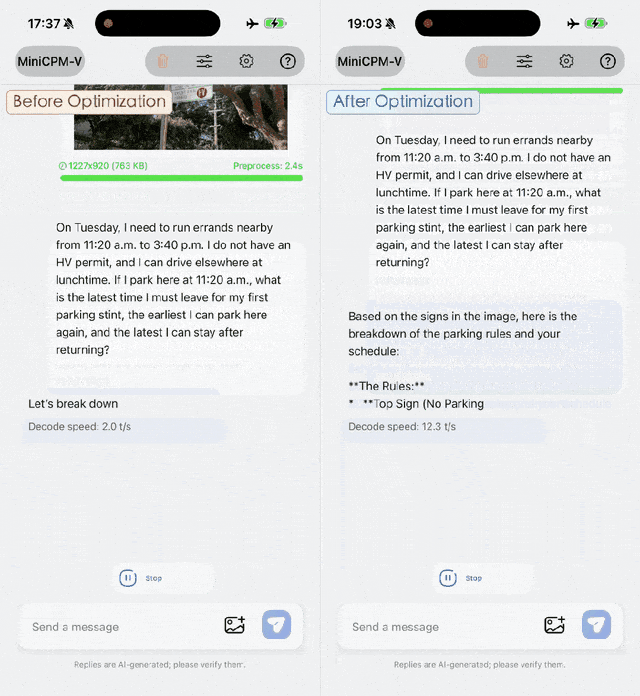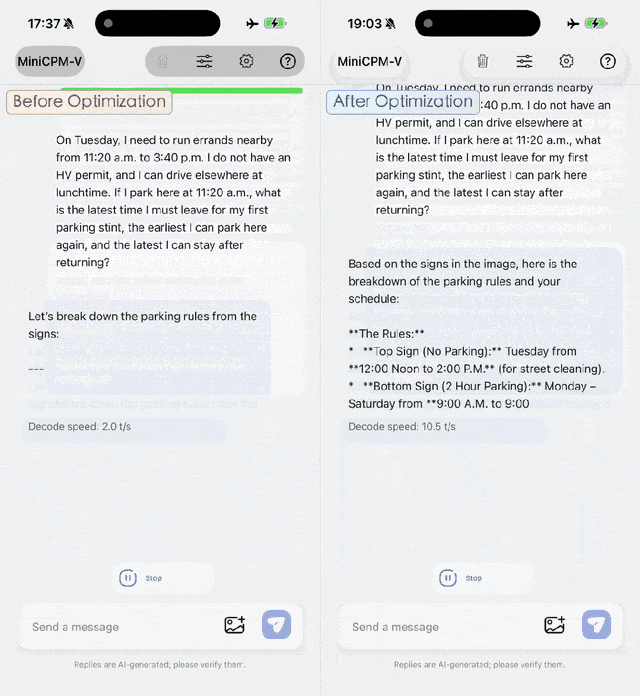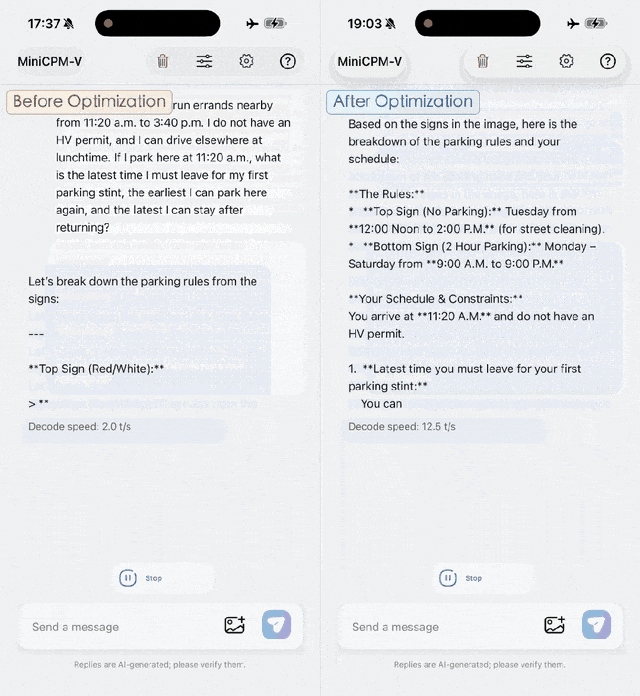
当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

# 模型文件本地加载,全程离线
model = MiniCPMVModel.from_pretrained(
    "openbmb/MiniCPM-V-4.7",
    local_files_only=True,      # 断网可用
    quantization="int4",        # 端侧量化
    max_memory="3GB",           # 内存预算控制
)

img = load_image("whiteboard_photo.jpg")

# 图像理解 + 流式生成
response = model.chat(
    image=img,
    question="总结这张白板图上的会议要点",
    stream=True,
)
for token in response:
    print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)
tokens_standard = model.count_vision_tokens(img, compress=False)
tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")
print(f"压缩编码: {tokens_compressed} tokens")
# 典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">
  <rect width="800" height="400" fill="#fafafa"/>
  <text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

  <!-- 图像输入 -->
  <rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>
  <text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>
  <text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

  <!-- 视觉编码 -->
  <rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>
  <text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>
  <text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

  <!-- LLM -->
  <rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>
  <text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>
  <text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

  <!-- 输出 -->
  <rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>
  <text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>
  <text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

  <!-- 箭头 -->
  <line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>
  <line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>
  <line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>
  <defs>
    <marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">
      <path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>
    </marker>
  </defs>

  <!-- 底部:端侧优势 -->
  <rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>
  <text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>
  <text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>
  <text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>
</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。

信息源:量子位《iPhone断网跑35B多模态!国产开源新模型,只占3G内存》 https://www.qbitai.com/2026/10/503109.html 查看原文 ↗

📋 多平台草稿预览 (12平台差异化改编)

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

模型文件本地加载,全程离线

model = MiniCPMVModel.from_pretrained(

"openbmb/MiniCPM-V-4.7",

local_files_only=True, # 断网可用

quantization="int4", # 端侧量化

max_memory="3GB", # 内存预算控制

)

img = load_image("whiteboard_photo.jpg")

图像理解 + 流式生成

response = model.chat(

image=img,

question="总结这张白板图上的会议要点",

stream=True,

)

for token in response:

print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)

tokens_standard = model.count_vision_tokens(img, compress=False)

tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")

print(f"压缩编码: {tokens_compressed} tokens")

典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

<!-- 图像输入 -->

<rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>

<text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

<!-- 视觉编码 -->

<rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>

<text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>

<text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

<!-- LLM -->

<rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>

<text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

<!-- 输出 -->

<rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>

<text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>

<text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

<!-- 箭头 -->

<line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<defs>

<marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>

</marker>

</defs>

<!-- 底部:端侧优势 -->

<rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>

<text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>

<text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>

<text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>

</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。


信息源:量子位《iPhone断网跑35B多模态!国产开源新模型,只占3G内存》 https://www.qbitai.com/2026/10/503109.html 标签:端侧大模型, 多模态, 开源

【视频脚本总览】总时长 60 秒 | 竖屏 9:16 | 语速中偏快,钩子短促有力,中段放慢讲清数字,结尾升调提问

【分镜 1|0-3秒|黄金钩子】

画面:手指划开 iPhone 控制中心,点亮飞行模式图标,特写

口播:iPhone 开飞行模式,跑 35B 大模型——这事,被国产团队干成了。

字幕:断网跑35B大模型?真的

【分镜 2|3-15秒|事件铺开】

画面:手机界面演示模型运行画面,切“开源”发布页面

口播:面壁智能,刚刚开源了多模态大模型 MiniCPM-V 4.7。35B,三百五十亿参数的规模。关键是:只要 3GB 内存,就能跑。3GB,什么概念?一部手机随便挤一挤就出来了。

字幕:面壁智能开源 MiniCPM-V 4.7|35B 参数|3GB 内存

【分镜 3|15-32秒|核心冲突】

画面:分屏对比:左边“云端大模型”图标不断上传数据,右边一部 iPhone 独立运行

口播:现在全行业都在卷什么?云端、万亿参数、越做越大。面壁智能反着来——把模型塞进你口袋。断网、无云端,数据不出手机。也就是说,你的照片、你的对话,不传到任何服务器。隐私泄露的风险,直接从根上砍掉。

字幕:无网络 无云端 无隐私泄露

【分镜 4|32-45秒|数据实证】

画面:屏幕大字弹出三个数字:35B / 3GB / iPhone

口播:记住这组反差:35B 的参数规模,3GB 的运行门槛,设备是 iPhone。以前这种规模的模型,你想都不敢想在手机上碰。而且它是开源的。开源意味着什么?免费、可下载、人人都能部署,不用订阅哪家云服务。

字幕:35B vs 3GB|开源 免费 人人可部署

【分镜 5|45-55秒|反直觉升华】

画面:手机揣回口袋的慢镜头,画面收束成口袋视角

口播:最有能力的人工智能,不一定要住在云上。它可以直接住在你口袋里——不联网,也照样干活。这个思路,可能会改写整个行业的走向。

字幕:AI 不一定住在云上

【分镜 6|55-60秒|互动CTA】

画面:口播人出镜,手指向评论区方向

口播:你会敢把聊天记录交给一个本地模型吗?评论区聊聊。关注我,3GB 跑 35B 这种狠活,下一个我第一时间讲。

字幕:你敢用本地大模型吗?评论区见

【BGM与节奏】

情绪:科技感、紧凑、略带悬念。开头 3 秒鼓点重击卡“飞行模式”点亮瞬间;15 秒处切低音铺垫讲隐私;32 秒数字弹出配三连音效;结尾 55 秒 BGM 收干净,只留人声提问。

【素材清单】

分镜1:实拍手机飞行模式操作特写

分镜2:模型运行界面录屏 + 发布页面截图

分镜3:分屏动画(云端上传 vs 本地运行示意)

分镜4:数字大字卡(35B / 3GB / iPhone)动态弹出

分镜5:手机入口袋慢镜头实拍

分镜6:真人出镜口播

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存 🔥

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。


当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。


📌 来源:量子位

#端侧大模型 #多模态 #开源

#科技资讯 #彩虹洋葱AI

问题:如何看待「iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存」?

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。


当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

模型文件本地加载,全程离线

model = MiniCPMVModel.from_pretrained(

"openbmb/MiniCPM-V-4.7",

local_files_only=True, # 断网可用

quantization="int4", # 端侧量化

max_memory="3GB", # 内存预算控制

)

img = load_image("whiteboard_photo.jpg")

图像理解 + 流式生成

response = model.chat(

image=img,

question="总结这张白板图上的会议要点",

stream=True,

)

for token in response:

print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)

tokens_standard = model.count_vision_tokens(img, compress=False)

tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")

print(f"压缩编码: {tokens_compressed} tokens")

典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

<!-- 图像输入 -->

<rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>

<text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

<!-- 视觉编码 -->

<rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>

<text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>

<text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

<!-- LLM -->

<rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>

<text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

<!-- 输出 -->

<rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>

<text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>

<text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

<!-- 箭头 -->

<line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<defs>

<marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>

</marker>

</defs>

<!-- 底部:端侧优势 -->

<rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>

<text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>

<text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>

<text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>

</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。


总结: 以上分析基于公开信息整理。核心在于理解这一事件/技术背后的驱动力,而非停留在表面叙事。欢迎在评论区交流你的看法。

📎 参考来源:量子位《iPhone断网跑35B多模态!国产开源新模型,只占3G内存》 https://www.qbitai.com/2026/10/503109.html

🔗 原文链接:https://www.qbitai.com/2026/10/503109.html

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

摘要:当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识……


当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

模型文件本地加载,全程离线

model = MiniCPMVModel.from_pretrained(

"openbmb/MiniCPM-V-4.7",

local_files_only=True, # 断网可用

quantization="int4", # 端侧量化

max_memory="3GB", # 内存预算控制

)

img = load_image("whiteboard_photo.jpg")

图像理解 + 流式生成

response = model.chat(

image=img,

question="总结这张白板图上的会议要点",

stream=True,

)

for token in response:

print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)

tokens_standard = model.count_vision_tokens(img, compress=False)

tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")

print(f"压缩编码: {tokens_compressed} tokens")

典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

<!-- 图像输入 -->

<rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>

<text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

<!-- 视觉编码 -->

<rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>

<text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>

<text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

<!-- LLM -->

<rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>

<text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

<!-- 输出 -->

<rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>

<text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>

<text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

<!-- 箭头 -->

<line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<defs>

<marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>

</marker>

</defs>

<!-- 底部:端侧优势 -->

<rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>

<text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>

<text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>

<text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>

</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。


📌 来源:量子位 | 标签:端侧大模型 · 多模态 · 开源

本文由彩虹洋葱 AI 自动聚合生成,仅供参考,不构成任何投资或决策建议。

【微博短帖 | 140字以内核心版】

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存:当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

#端侧大模型 #多模态 #开源


【微博长帖 | 可配图 9 宫格版】

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

#端侧大模型 #多模态 #开源 🔗 https://www.qbitai.com/2026/10/503109.html

📺 B站视频脚本 | 时长:3-5分钟

【片头 0:00-0:15】BGM起 → 标题字幕弹出

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

【引子 0:15-0:45】制造悬念

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

【时间轴分镜】

├ [00:02] 当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPho……

├ [02:04] 先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对……

├ [04:06] 换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。……

├ [06:08] 面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做……

├ [08:10] 第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB……

├ [结尾] 总结 + 求三连关注

【弹幕互动引导】

  • "觉得有用的扣 1"
  • "不同观点的弹幕见"
  • 结尾设置投票:你看好这个方向吗?A.看好 B.观望 C.不看好

🏷️ 标签:端侧大模型, 多模态, 开源

【视频脚本总览】总时长 45-60 秒 | 竖屏 9:16 | 一句话定位:别人家 AI 要 70 个 G 显存,国产开源这个 3 个 G 就能塞进 iPhone,断网照用还不花钱。

【分镜 1|0-3秒|利益点开场】

画面:手机怼脸特写,飞行模式图标先亮出来,再弹出一张白板照片被 AI 秒总结的画面。

口播:你手机断网,也能让 AI 帮你总结会议要点了——只要 3 个 G 内存,一分钱不花。

字幕:断网也能用的 AI?就 3 个 G!

【分镜 2|3-30秒|正文讲清】

画面:左右分屏对比——左边云端机房冒出"70GB"红字,右边手机屏幕亮出"3GB"绿字;随后切白板拍照、流式出字的演示。

口播:这是国产公司面壁智能刚开源的 MiniCPM-V 4.7,多模态的,能看图能聊天,全程在你手机上跑,照片不用传云端,隐私不出机器。有人说手机能跑啥好模型?这么说吧,效果对标的是 35B 的大模型,那玩意儿原样跑起来 FP16 权重要 70 个 G 以上显存,就算压到 4bit 也得 18 个 G。它不是硬塞,而是用知识蒸馏和架构创新,从头训练一个天生适合手机的小模型,效果对标大块头。手机芯片算力才数据中心卡的百分之一量级,所以它把一张图上千个视觉 Token 压到几十个,内存直接降一个数量级,这才跑得动。

字幕:对标 35B 效果|3GB 离线跑|照片不出手机

【分镜 3|30-45秒|实在收尾】

画面:回到手持手机实拍,博主对镜头说话,结尾打出"开源免费"大字。

口播:关键是它开源的,不要钱。你拍张白板、拍张表格,直接让它给你总结,断网地铁里照样用。问题来了——你敢不敢把整个相册交给手机里的 AI?评论区说说你第一个想让它干啥。

字幕:开源免费,评论区聊聊你想用它干啥

【BGM与节奏】轻快电子鼓点,前 3 秒鼓点重音卡"3 个 G";分镜 2 语速稍快但吐字清晰,"70 个 G""18 个 G""百分之一"三处停顿半秒加重;结尾放慢,留给互动。

【素材清单】

  • 【配图建议:手机飞行模式 + 白板照片被 AI 总结的屏幕录制】
  • 【配图建议:70GB 显存 vs 3GB 内存分屏对比大字图】
  • 【配图建议:拍白板图 → 流式生成会议要点的端侧演示画面】
  • 【配图建议:"开源免费"结尾定格字卡】

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

前言

当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。


当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

模型文件本地加载,全程离线

model = MiniCPMVModel.from_pretrained(

"openbmb/MiniCPM-V-4.7",

local_files_only=True, # 断网可用

quantization="int4", # 端侧量化

max_memory="3GB", # 内存预算控制

)

img = load_image("whiteboard_photo.jpg")

图像理解 + 流式生成

response = model.chat(

image=img,

question="总结这张白板图上的会议要点",

stream=True,

)

for token in response:

print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)

tokens_standard = model.count_vision_tokens(img, compress=False)

tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")

print(f"压缩编码: {tokens_compressed} tokens")

典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

<!-- 图像输入 -->

<rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>

<text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

<!-- 视觉编码 -->

<rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>

<text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>

<text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

<!-- LLM -->

<rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>

<text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

<!-- 输出 -->

<rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>

<text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>

<text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

<!-- 箭头 -->

<line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<defs>

<marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>

</marker>

</defs>

<!-- 底部:端侧优势 -->

<rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>

<text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>

<text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>

<text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>

</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。


总结

本文梳理了相关技术/事件的核心脉络。如有错误欢迎在评论区指正。


📂 分类:端侧大模型 · 多模态 · 开源

© 本文由彩虹洋葱 AI 自动聚合,转载请注明出处。

3GB 内存跑出 35B 效果:面壁开源 MiniCPM-V 4.7,iPhone 断网可用

70GB。这是 35B 级模型 FP16 权重需要的显存;量化到 4bit 也得 18GB。而面壁智能刚开源的 MiniCPM-V 4.7,只要 3GB 内存,就能在 iPhone 上离线跑多模态推理——没网、没云端,数据不出设备。

对天天和内存限额、隐私合规打交道的开发者来说,这不是又一条模型新闻,而是一条可落地的部署路线。

先做预期管理:不是 35B 塞进手机

它不是把原封不动的 35B 模型压到手机上,而是让一个轻量级端侧模型,通过知识蒸馏和架构创新,对标 35B 级多模态模型的效果——对标的是效果,不是参数量。

这个区分很重要。端侧模型领域这几年最关键的范式转变,就是从“如何在手机上压缩大模型”变成“如何从头训练一个天生适合端侧的模型”。面壁走的路线,业界一般称为“比特斯拉(Bitter Lesson)反其道而行”的高效路线:不无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

三座大山,数字摆在这里

内存。 iPhone 的内存和系统、其他 App 共享,iOS 给单个 App 的限额非常苛刻。70GB 和 18GB 都进不了这个预算,3GB 意味着模型本体、视觉编码器、KV Cache、运行时开销要全部挤进同一空间。 算力。 手机芯片的算力大概只有数据中心 A100/H100 的百分之一量级。要做到用户可接受的响应速度(每秒 10 个 token 以上),每一层计算都不能浪费。 视觉 Token。 这是多模态特有的坑:一张高分辨率图片经 ViT 编码可能产生上千个视觉 Token,KV Cache 随上下文线性增长,很快吃光内存预算。

MiniCPM-V 从 2.0 到 4.7 的迭代,正是围绕这三座山:视觉 Token 压缩(把每张图的 Token 数大幅减少)、高分辨率自适应切分、端侧量化与推理框架的深度协同优化。Token 数从 1000+ 压到几十,内存占用下降一个数量级——KV Cache 占用和推理耗时同步下来,这是端侧多模态能不能“可用”的胜负手。

部署有多简单,代码说话

本地加载、断网可用、int4 量化,三个开关就是端侧部署的全部核心:

from mini_cpm_v import MiniCPMVModel, load_image

# 模型文件本地加载,全程离线
model = MiniCPMVModel.from_pretrained(
    "openbmb/MiniCPM-V-4.7",
    local_files_only=True,      # 断网可用
    quantization="int4",        # 端侧量化
    max_memory="3GB",           # 内存预算控制
)

img = load_image("whiteboard_photo.jpg")

# 图像理解 + 流式生成
response = model.chat(
    image=img,
    question="总结这张白板图上的会议要点",
    stream=True,
)
for token in response:
    print(token, end="", flush=True)

Token 压缩的效果可以自己验证:

# 视觉Token数对比(示意)
tokens_standard = model.count_vision_tokens(img, compress=False)
tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")
print(f"压缩编码: {tokens_compressed} tokens")
# 典型结果:1000+ → 几十,内存占用下降一个数量级

【配图建议:MiniCPM-V 4.7 端侧多模态推理流水线示意,从高分辨率图像自适应切分、视觉 Token 压缩、INT4 量化解码到流式输出】

【配图建议:iPhone 上离线运行的实测界面动态演示】

对日常开发的启示

一是隐私场景有了新解法。医疗影像、会议白板、私有文档这类不能出域的数据,离线推理直接消掉了数据外传这一环,合规成本从架构层面降下来。

二是成本模型要重新算。断网可用 + 本地运行,意味着没有按 token 计费的 API 账单,也没有网络抖动带来的延迟——对响应速度敏感的工具类 App,这个账值得算一算。

三是范式值得记住:别急着把大模型往下压,先想想有没有“天生适合端侧”的路线。手机算力只有 A100 的百分之一,靠堆不行,只能靠效率创新。

开源已就位,模型在 openbmb/MiniCPM-V-4.7。建议拉下来跑一遍上面那段 Token 压缩对比,看看 1000+ → 几十是不是真的——数字不会骗人。

iPhone断网也能跑35B多模态大模型?国产开源MiniCPM-V 4.7,只要3G内存

【导语】 当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。
本文目录:

(正文见下)


当所有人都在卷云端万亿参数的时候,有一群人悄悄把35B的多模态大模型塞进了你的口袋。面壁智能刚刚开源的MiniCPM-V 4.7,仅需3GB内存,就能在iPhone上离线运行——没有网络、没有云端、没有隐私泄露的风险。

一件事先说清楚:这不是“阉割版”

先泼一盆冷水式的预期管理:手机上跑的当然不是原封不动的35B模型。MiniCPM-V 4.7的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标35B级多模态模型的效果。

换句话说,它对标的是效果,而不是参数量。这也是端侧模型领域近年最重要的范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。

面壁的这条技术路线,业界一般称之为“比特斯拉(Bitter Lesson)反其道而行”的高效路线——不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

端侧多模态的三座大山

要在iPhone上流畅跑一个多模态模型,要翻过三座大山:

第一座山:内存。 iPhone的内存是和系统、其他App共享的,iOS给单个App的内存限额非常苛刻。传统方式加载一个35B级别的模型,光是权重就要占用70GB以上的显存(FP16),就算量化到4bit也要18GB左右。3GB的预算意味着模型本体、视觉编码器、KV Cache、运行时开销全部要挤进这个空间。 第二座山:算力。 手机芯片的算力大概只有数据中心A100/H100的百分之一量级。要做到用户可接受的响应速度(比如每秒10个token以上的生成速度),每一层计算都不能浪费。 第三座山:多模态的额外开销。 视觉Token是出了名的“内存杀手”——一张高分辨率图片经过ViT编码后可能产生上千个视觉Token,KV Cache随上下文线性增长,很快就会把内存预算吃光。

MiniCPM-V系列多年来正是围绕这三座山持续迭代。从早期的MiniCPM-V 2.0到如今的4.7,其技术积累包括高效的视觉Token压缩(大幅减少每张图占用的Token数)、高分辨率自适应切分策略、以及端侧量化和推理框架的深度协同优化。

一段代码看懂端侧部署有多简单

开源生态的易用性,往往决定了技术能不能真正落地。以典型的端侧推理流程为例:

from mini_cpm_v import MiniCPMVModel, load_image

模型文件本地加载,全程离线

model = MiniCPMVModel.from_pretrained(

"openbmb/MiniCPM-V-4.7",

local_files_only=True, # 断网可用

quantization="int4", # 端侧量化

max_memory="3GB", # 内存预算控制

)

img = load_image("whiteboard_photo.jpg")

图像理解 + 流式生成

response = model.chat(

image=img,

question="总结这张白板图上的会议要点",

stream=True,

)

for token in response:

print(token, end="", flush=True)

视觉Token压缩的效果,可以直接用代码验证:

# 视觉Token数对比(示意)

tokens_standard = model.count_vision_tokens(img, compress=False)

tokens_compressed = model.count_vision_tokens(img, compress=True)

print(f"标准编码: {tokens_standard} tokens")

print(f"压缩编码: {tokens_compressed} tokens")

典型结果:1000+ → 几十,内存占用下降一个数量级

Token数降一个数量级,意味着KV Cache的内存占用和推理耗时同步大幅下降——这是端侧多模态能否可用的关键胜负手。

整体架构:一条流水线打通“看图 → 理解 → 生成”

<svg viewBox="0 0 800 400" xmlns="http://www.w3.org/2000/svg" font-family="PingFang SC, Microsoft YaHei, Noto Sans SC, sans-serif">

<rect width="800" height="400" fill="#fafafa"/>

<text x="400" y="45" text-anchor="middle" font-size="22" font-weight="bold" fill="#312e81">MiniCPM-V 4.7 端侧多模态推理流水线</text>

<!-- 图像输入 -->

<rect x="30" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="105" y="120" text-anchor="middle" font-size="16" fill="#fff">高分辨率图像</text>

<text x="105" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">自适应切分</text>

<!-- 视觉编码 -->

<rect x="230" y="90" width="150" height="70" rx="10" fill="#8b5cf6"/>

<text x="305" y="120" text-anchor="middle" font-size="16" fill="#fff">视觉编码器</text>

<text x="305" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">高效Token压缩</text>

<!-- LLM -->

<rect x="430" y="90" width="150" height="70" rx="10" fill="#6366f1"/>

<text x="505" y="120" text-anchor="middle" font-size="16" fill="#fff">轻量LLM解码</text>

<text x="505" y="143" text-anchor="middle" font-size="13" fill="#e0e7ff">INT4量化推理</text>

<!-- 输出 -->

<rect x="630" y="90" width="140" height="70" rx="10" fill="#8b5cf6"/>

<text x="700" y="120" text-anchor="middle" font-size="16" fill="#fff">流式输出</text>

<text x="700" y="143" text-anchor="middle" font-size="13" fill="#ede9fe">端侧实时生成</text>

<!-- 箭头 -->

<line x1="180" y1="125" x2="228" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="380" y1="125" x2="428" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<line x1="580" y1="125" x2="628" y2="125" stroke="#6366f1" stroke-width="3" marker-end="url(#arrow)"/>

<defs>

<marker id="arrow" markerWidth="10" markerHeight="10" refX="8" refY="3" orient="auto">

<path d="M0,0 L8,3 L0,6 Z" fill="#6366f1"/>

</marker>

</defs>

<!-- 底部:端侧优势 -->

<rect x="60" y="220" width="680" height="140" rx="14" fill="#eef2ff" stroke="#8b5cf6" stroke-width="1.5"/>

<text x="400" y="255" text-anchor="middle" font-size="17" font-weight="bold" fill="#4338ca">3GB内存 · 全程离线 · 数据不出设备</text>

<text x="400" y="290" text-anchor="middle" font-size="14" fill="#5b21b6">视觉Token压缩 → KV Cache内存降低一个数量级</text>

<text x="400" y="325" text-anchor="middle" font-size="14" fill="#5b21b6">量化 + 推理框架协同优化 → 手机芯片实时生成</text>

</svg>

为什么“离线多模态”这件事很重要?

有人可能会问:云端模型这么强了,端侧折腾图什么?

第一,隐私。 相册、截图、文档、摄像头画面——这些是最敏感的个人数据。多模态模型要真正成为“随身助手”,必然要接触这些数据。数据不出设备,是隐私问题的根本解法,而不是靠厂商的承诺。 第二,可靠性和成本。 断网可用、零API费用、无延迟抖动。对于工业巡检、无网环境作业、涉密场景等应用,端侧几乎是唯一选项。 第三,产业层面的信号。 面壁一直强调“模型效率是AI时代的生产力”。当Scaling Law的边际收益开始被质疑,能效比这条路线的战略价值正在被重新定价。苹果、高通、联发科都在芯片层面为端侧AI加码,而一个开源的、能在消费级手机上跑的多模态模型,给了所有开发者一个可以直接拿去做产品的底座。

冷静看待:端侧模型的天花板

当然也要客观:受限于参数量,端侧模型在复杂的推理链、长文档理解、专业知识问答上,和云端旗舰模型仍有明显差距。35B对标的更多是多模态感知和日常理解任务,而不是让它替你写复杂代码、做数学竞赛题。

正确的打开方式是端云协同:日常感知类任务在端侧完成,重任务上云。而MiniCPM-V 4.7这类模型的价值,在于把“日常感知”这一层彻底免费化、私有化。

写在最后

从“手机跑不动大模型”到“3GB内存离线跑多模态”,这个领域的迭代速度超出很多人预期。开源 + 端侧 + 多模态,三个关键词叠加在一起,意味着下一代AI原生App的技术门槛,正在被快速拉低。

对开发者来说,现在也许正是把“做一个离线AI应用”从愿望清单里捞出来的时候了。


关键词:端侧大模型, 多模态, 开源 声明:本文由彩虹洋葱 AI 智能聚合生成,仅供信息参考。

地铁断网那一刻,我的 iPhone 还在“思考”

地铁钻进隧道的瞬间,信号格空了。邻座的人开始烦躁地刷新页面,我却举起手机对着车厢里贴的一张线路示意图问了一句,它流畅地回答了我,一秒都没卡。

配图

因为它的“脑子”里,装着一个完整的模型。

这不是科幻。面壁智能刚刚开源的 MiniCPM-V 4.7,只要 3GB 内存,就能在 iPhone 上离线运行多模态任务。没有网络,没有云端,也就没有隐私泄露的风险——你拍的照片,从来没离开过你的手机。

【配图建议:iPhone 屏幕上正在识别一张图片并流式生成文字的界面】

先把一件事说清楚:这不是“阉割版”

我第一反应也是怀疑:手机上能跑什么模型?

答案是,跑的当然不是原封不动的 35B 模型。MiniCPM-V 4.7 的核心思路,是让一个轻量级的端侧模型,通过知识蒸馏和架构创新,达到对标 35B 级多模态模型的效果。

对标的是效果,而不是参数量。这句话听起来像公关话术,但数字摆出来你就明白了:传统方式加载一个 35B 级别的模型,光是权重在 FP16 下就要占用 70GB 以上显存,就算量化到 4bit 也要 18GB 左右。而 iPhone 的内存是和系统、其他 App 共享的,iOS 给单个 App 的限额苛刻得很。3GB 的预算,意味着模型本体、视觉编码器、KV Cache、运行时开销,全部要挤进这一个空间。

再算一笔算力的账:手机芯片的算力,大概只有数据中心 A100/H100 的百分之一量级。在这种条件下要做到每秒 10 个 token 以上的生成速度,每一层计算都不能浪费。

这就是为什么这件事让我震动——不是“手机变快了”,而是有人换了一条路。

三座大山,和最聪明的那把钥匙

要在手机上流畅跑多模态模型,要翻三座山:内存、算力,还有视觉 Token 这个“内存杀手”。一张高分辨率图片经过 ViT 编码后,可能产生上千个视觉 Token,KV Cache 随上下文线性增长,很快就把内存预算吃光。

MiniCPM-V 系列的做法,是把视觉 Token 压缩——从 1000+ 压到几十。Token 数降一个数量级,KV Cache 的内存占用和推理耗时同步大幅下降。这是端侧多模态能不能“可用”的胜负手。从早期的 MiniCPM-V 2.0 到如今的 4.7,这条路线他们迭代了很多年。

部署的门槛也低得让我意外。开源仓库里的用法大致就是这样:

from mini_cpm_v import MiniCPMVModel, load_image

# 模型文件本地加载,全程离线
model = MiniCPMVModel.from_pretrained(
    "openbmb/MiniCPM-V-4.7",
    local_files_only=True,      # 断网可用
    quantization="int4",        # 端侧量化
    max_memory="3GB",           # 内存预算控制
)

img = load_image("whiteboard_photo.jpg")

# 图像理解 + 流式生成
response = model.chat(
    image=img,
    question="总结这张白板图上的会议要点",
    stream=True,
)

local_files_only=True,断网可用。开会时拍下一整面白板,手机照样帮你总结要点——这在以前,我想都不敢想。

【配图建议:白板照片被模型识别后生成会议要点总结的演示界面】

真正值得带走的,是一条路线之争

业界把面壁的这条技术路线,称为与“比特斯拉(Bitter Lesson)”反其道而行的高效路线,不去无限堆算力和数据,而是在模型架构、训练策略、推理优化上做极致的效率创新。

这背后是一个范式转变:从“如何在手机上压缩大模型”,变成“如何从头训练一个天生适合端侧的模型”。前者的天花板是压缩损耗,后者是重新定义什么叫“够用的智能”。

当所有人都在卷云端万亿参数的时候,有一群人悄悄把 35B 级效果的多模态能力,塞进了你的口袋。

下次地铁进隧道,你不妨想想:真正属于你的 AI,也许不该住在别人的服务器上。

🚀 多平台发布

点击「复制」获取平台专属文案,到各平台编辑器(App/网页)粘贴即可发布。
有密钥的 4 个平台(微信服务号 / 头条 / 百家号 / 微博)可自动发布,密钥填好后自动点亮。

平台状态操作
💬 公众号🔑 待配置密钥
🎵 抖音📋 手动复制
📕 小红书📋 手动复制
🤔 知乎📋 手动复制
📰 今日头条🔑 待配置密钥
🐦 微博🔑 待配置密钥
📺 B站📋 手动复制
⚡ 快手📋 手动复制
💻 CSDN📋 手动复制
⛏️ 掘金📋 手动复制
📝 百家号🔑 待配置密钥
✍️ 简书📋 手动复制