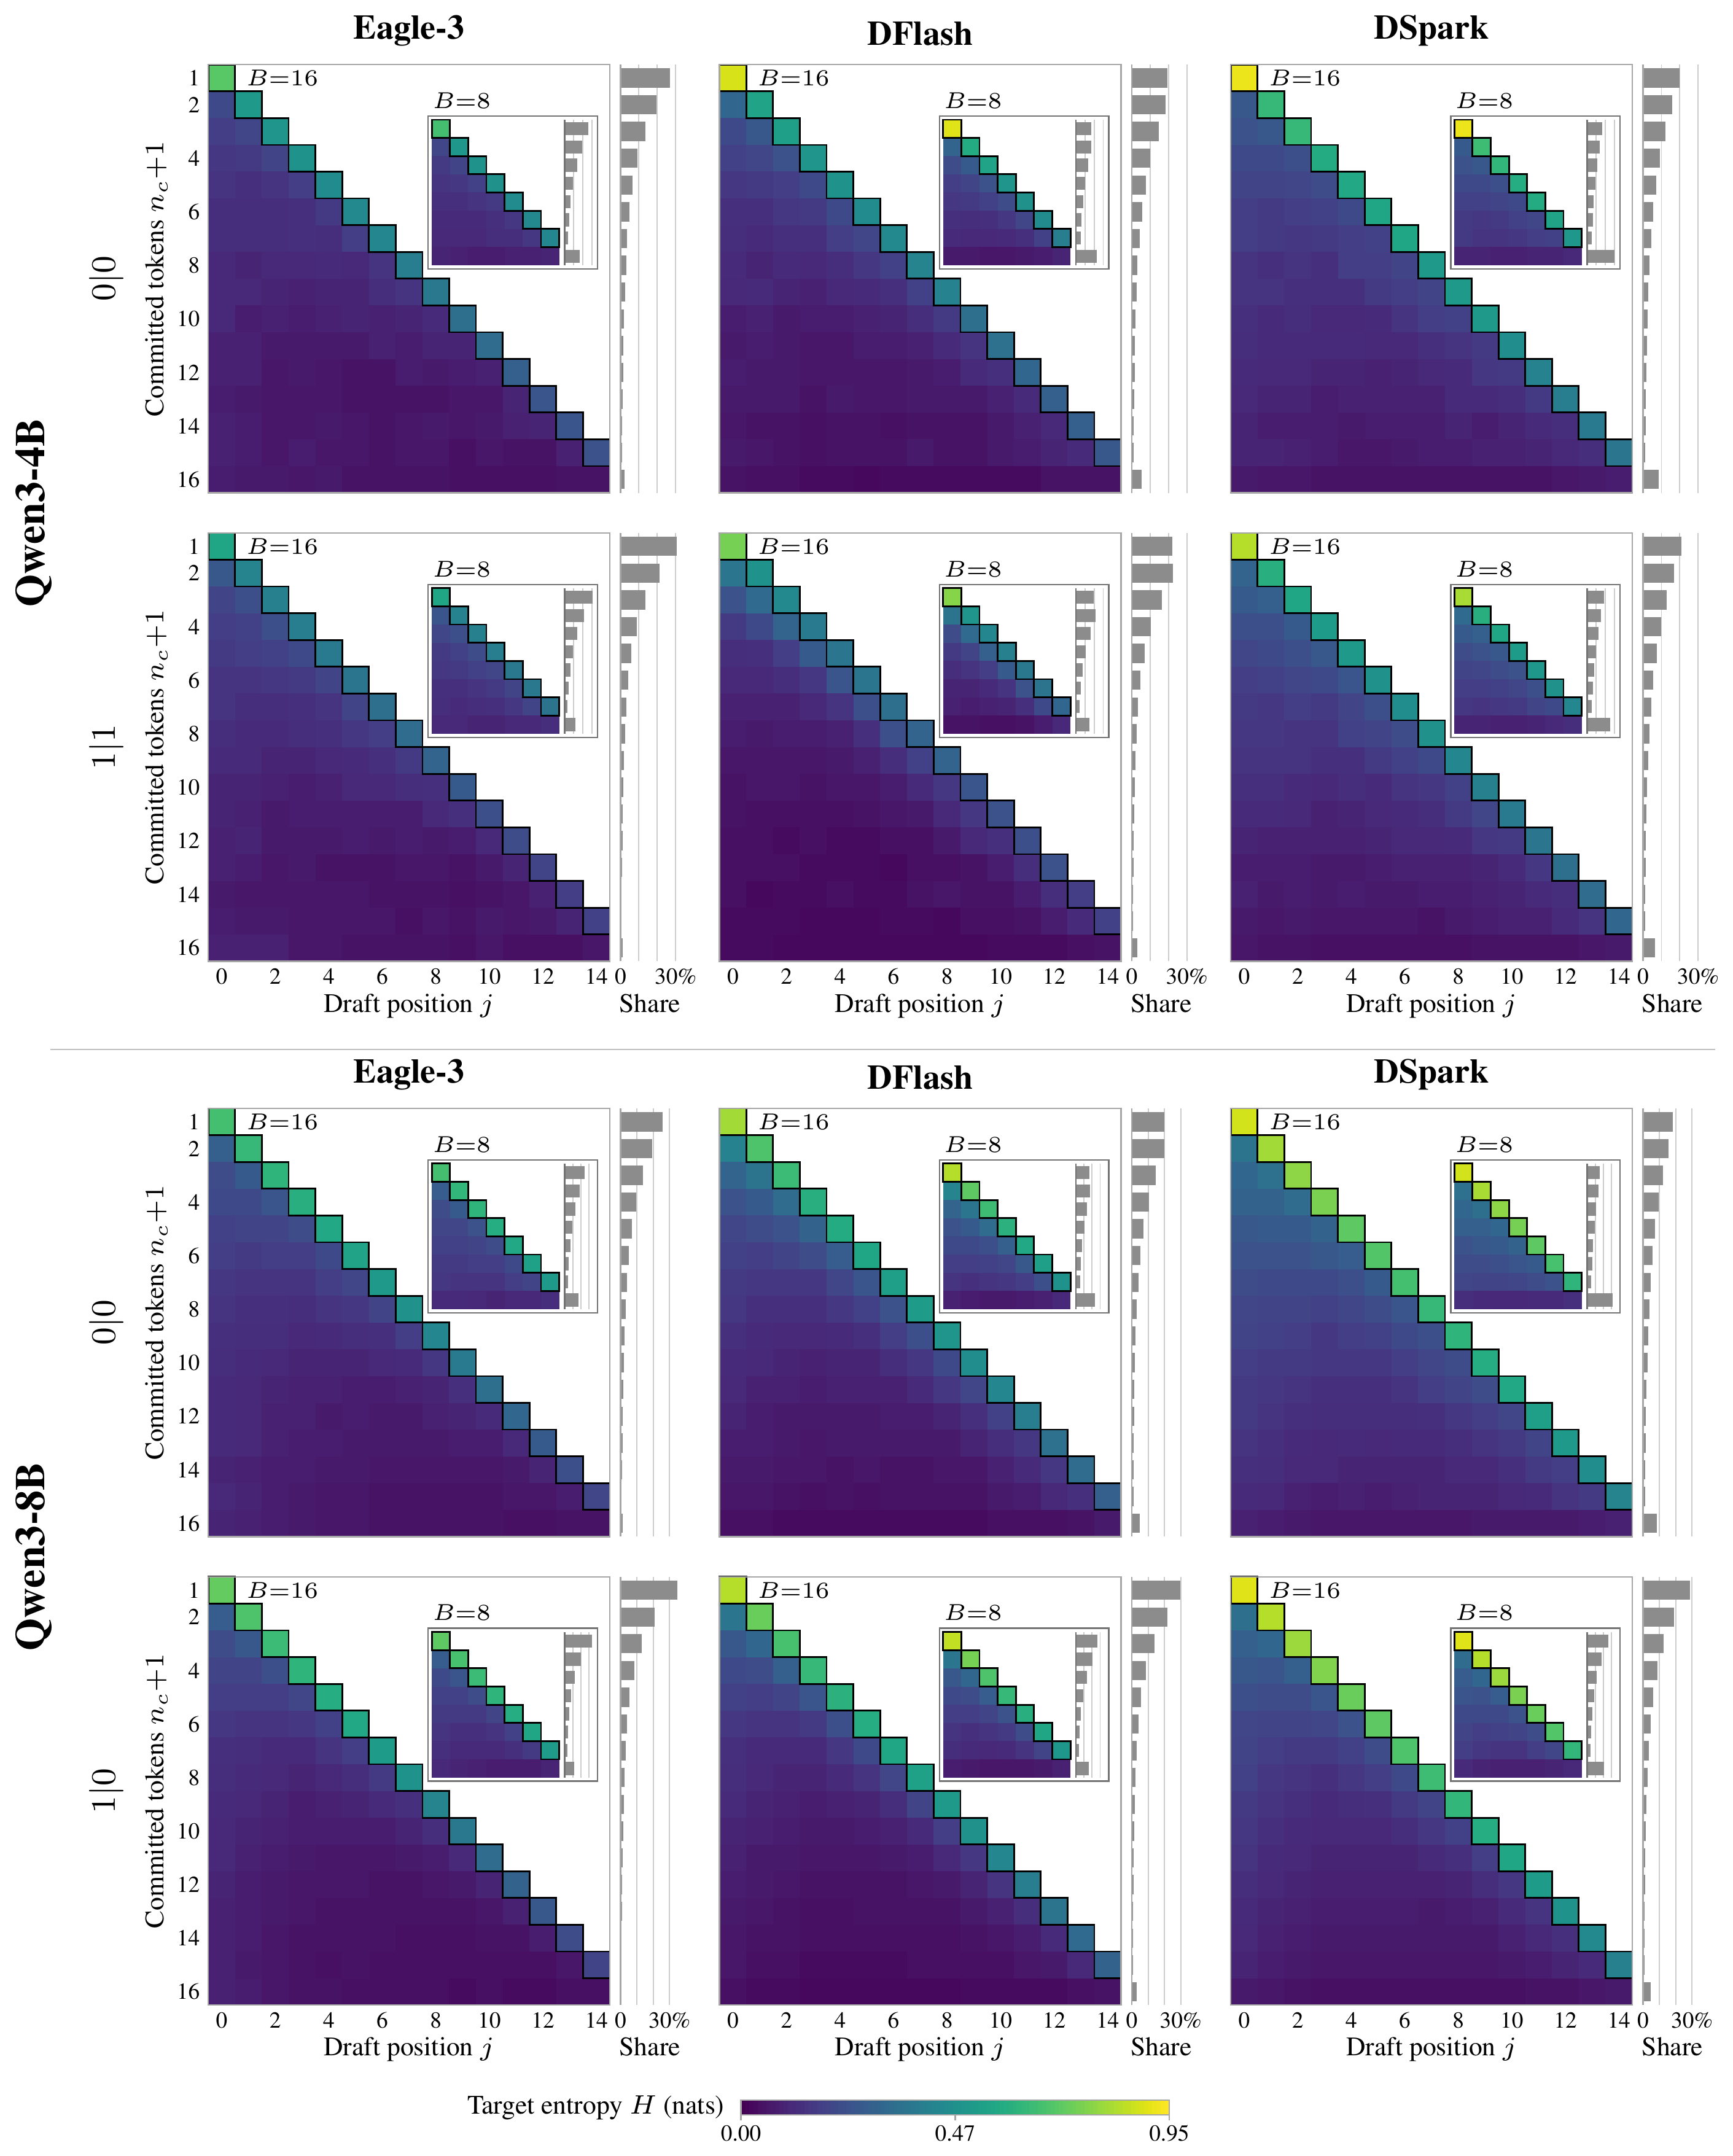
在大模型推理加速的赛道上,投机采样早已是标配技术。但一个反直觉的事实正在被忽视:Draft 模型被主模型接受的 token 数量越多,推理速度未必越快。百度 ERNIE 团队最近开源的 DCore 项目,用系统性的实验戳破了这层窗户纸——而长期以来基于「公平性不足」的对比,可能让整个社区对 Drafter 的选型判断都出现了偏差。
一、先补课:投机采样到底在加速什么

大模型自回归推理是典型的访存受限任务:生成一个 token 需要把几十 GB 的模型权重在显存里“过”一遍,而算力大量闲置。投机采样的思路非常巧妙——用一个小得多的 Draft 模型(Drafter)先快速“猜”出 k 个 token,再让目标大模型一次性并行验证。验证一次的成本约等于生成一个 token,但通过验证的多个 token 却被“白嫖”了,从而实现 2~3 倍的加速。
这套机制的核心指标有两个:
1. 平均接受长度 τ(tau):每轮验证中,Draft 提议的 token 平均有几个被主模型接受;
2. 单步延迟:Drafter 生成 k 个 token + 主模型验证一次的总耗时。
直觉上,τ 越大越好——毕竟接受的 token 越多,说明“猜得越准”。但 DCore 的作者们指出:这个直觉存在系统性偏差。

二、核心观点:More accepted tokens ≠ faster LLMs
DCore 项目标题里那句话一针见血。问题出在哪?
接受长度 τ 是有代价的,而这个代价经常被隐藏。 一个更大的 Drafter、或者经过蒸馏对齐的 Drafter,确实能提高 τ,但它的单 token 生成延迟也随之上升。推理的整体吞吐可以近似表示为:Speedup ≈ τ / (1 + k · t_draft / t_target)
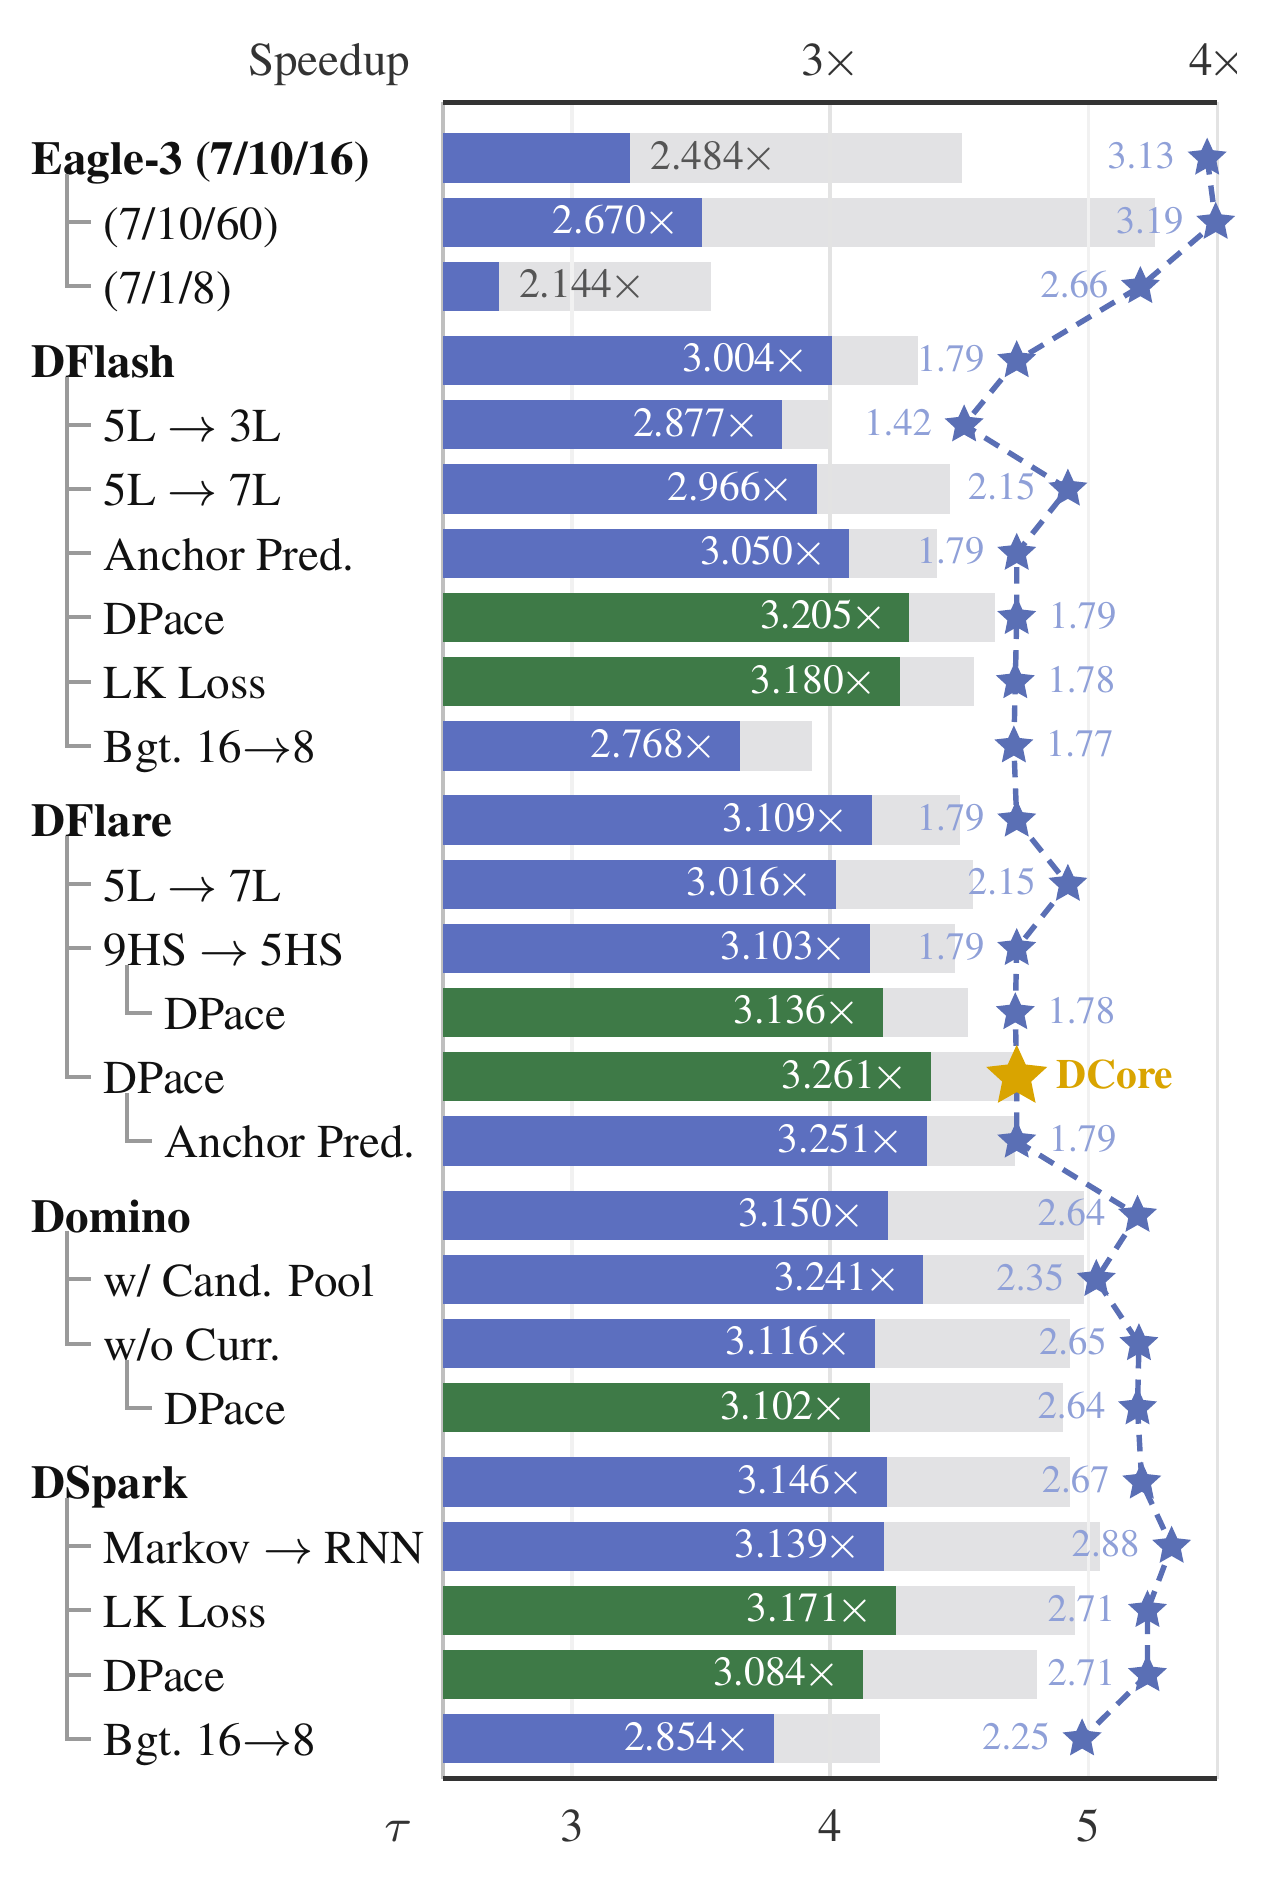
也就是说,最终加速比取决于 τ 的增益能否覆盖 Drafter 的额外延迟。DCore 用实测数据证明:在某些主流模型组合上,接受长度排名第一的 Drafter,端到端吞吐反而排不进前三。
更有意思的是第二个发现:当 τ 的统计口径不统一时,Drafter 之间的排名会彻底洗牌。 不同论文在评测时使用的验证策略、温度、采样方式、是否共享 KV Cache、验证窗口长度等因素各不相同,导致文献中“谁是最强 Drafter”的结论互相矛盾。DCore 通过统一评测协议,让这些对比第一次站在了同一条起跑线上。

三、DCore 提供了什么
作为百度 ERNIE 官方仓库,DCore 不只是发观点,而是给出了一套可复现的公平评测框架:
- 统一验证协议:固定采样参数、验证算法和硬件环境,消除混杂变量;
- 多 Drafter 排行:在不同目标模型和任务分布下,同时报告接受长度与端到端吞吐两个维度;
- 收益边界分析:明确指出在什么条件下(目标模型多大、Drafter 多小、任务多“可猜”)提升接受率才是划算的。
典型的使用方式如下(示意代码):
# 安装
pip install dcore

# 在统一协议下评测某个 Drafter
dcore evaluate \
  --target Qwen2.5-72B-Instruct \
  --drafter your-draft-model \
  --tasks mmlu,gsm8k,alpaca \
  --metrics accepted_length,throughput \
  --batch-size 1 --temperature 0.0
from dcore import SpeculativeEngine, Drafter

# 同时观测接受长度与真实吞吐
engine = SpeculativeEngine(
    target="Qwen2.5-72B-Instruct",
    drafter=Drafter.from_pretrained("your-draft-model"),
    speculative_steps=4,
)
result = engine.benchmark(prompts)
print(result.accepted_length)  # 平均接受长度
print(result.tokens_per_sec)   # 端到端吞吐 —— 评测的落脚点
四、对从业者的三点启示
第一,选 Drafter 别只看 benchmark 表上的接受长度。 如果你的目标模型本身很小(如 7B 级别),t_target 已经很低,一个“猜得准但偏慢”的 Drafter 很可能得不偿失;反之在 70B+ 的模型上, Drafter 的延迟占比更小,值得追求更高的 τ。 第二,警惕跨论文的数字直接对比。 同一个 Drafter 在不同论文里的排名可以差出好几名,原因往往不是实现优劣,而是协议不同。复现优先,引用谨慎。 第三,任务分布影响 τ,进而影响选型。 代码生成、数学推理这类高结构化任务,Drafter 更容易猜对;开放式闲聊则相反。生产环境应以自身流量分布做评测,而不是迷信公开榜单。五、写在最后
推理加速领域的“内卷”,很大程度是指标的内卷。DCore 的价值不在于提出了新算法,而在于把尺子校准了——当一个社区开始认真讨论“怎么测”的时候,才真正走到了“怎么做得更好”的前夜。目前仓库热度尚在早期,但作为 ERNIE 官方出品,其工程完整度和方法论严谨性值得持续关注。
 一、先厘清投机采样到底在加速什么