每当谈论AI成本,高管们的第一反应永远是“GPU多少钱一小时”。但MIT Technology Review的最新报道揭示了一个被普遍忽视的真相:推理(Inference)在后台疯狂产生的数据,正在让企业的存储账单以肉眼可见的速度膨胀——而绝大多数公司根本没有把这笔钱算进AI预算里。
被忽略的真相:AI的成本不止是算力

过去三年,企业界对AI成本的理解基本停留在“买卡”和“租算力”层面。训练一个模型要烧掉数百万美元的GPU时间,推理一次调用的token价格被压到令人发指的低点——一切看起来都在往“普惠”的方向走。
但MIT TR的报道指出,一个反直觉的事实是:推理产生的后端数据,才是让CFO们半夜惊醒的“灰犀牛”。
推理是什么?就是用户每次问ChatGPT一句话、每次让AI写一封邮件、每次调用一次企业内部AI助手的那个过程。问题在于:每一次推理调用,都不是“发生完就消失”的。
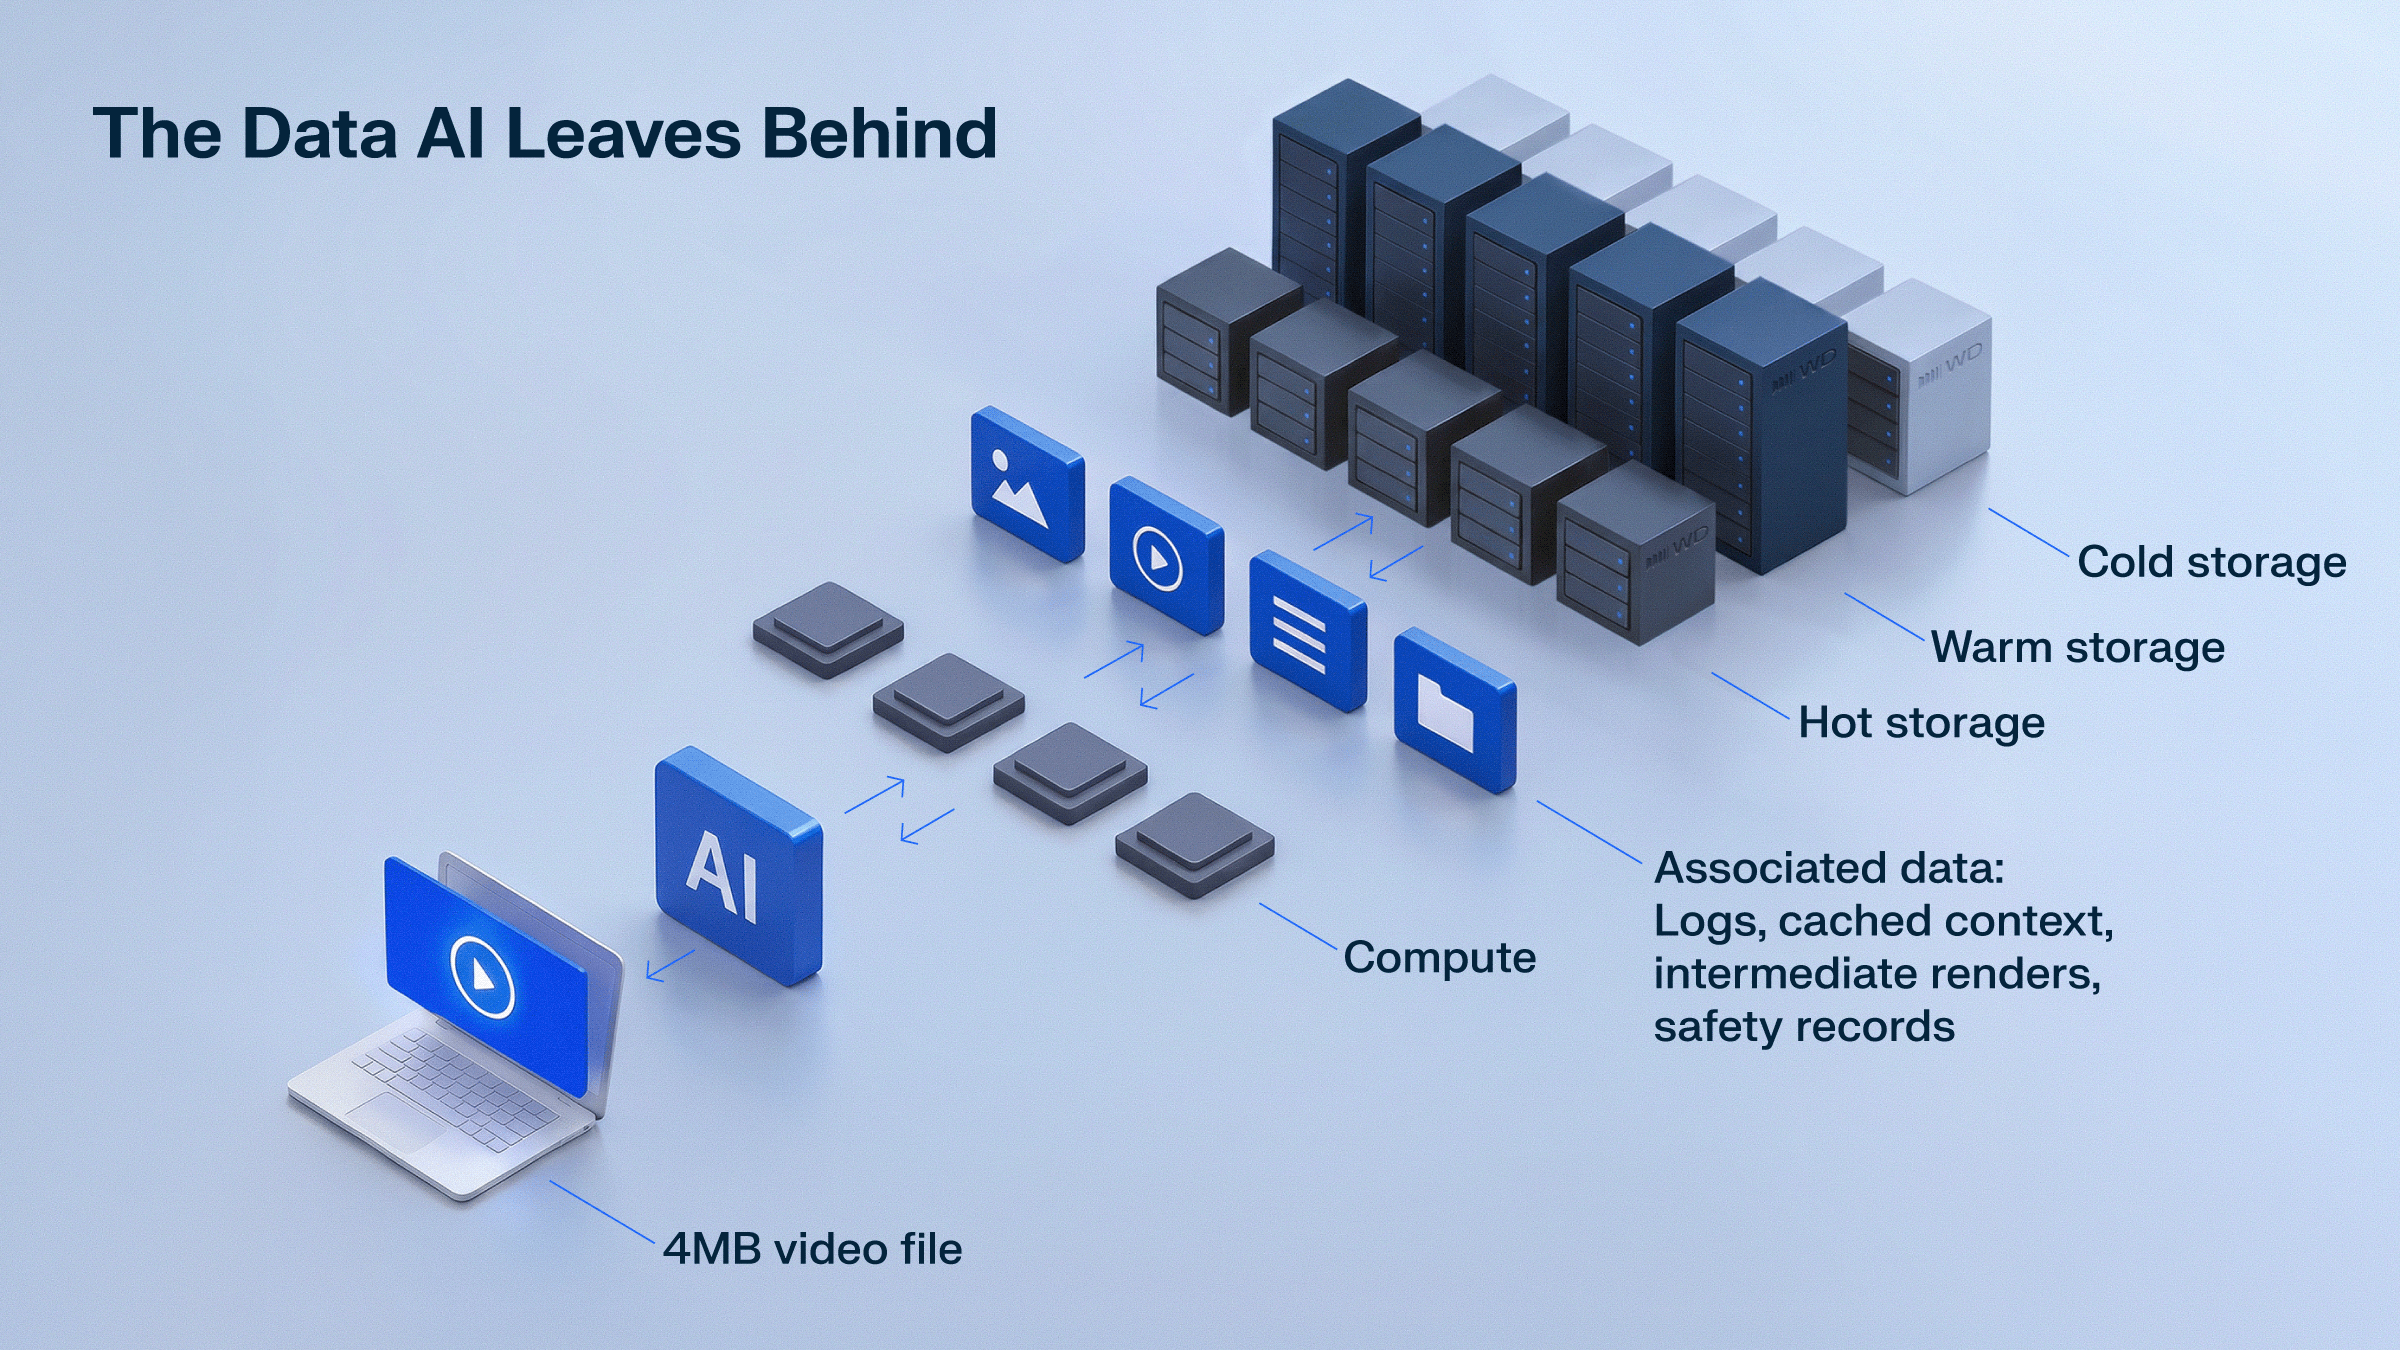
具体来说,推理过程会留下这些数据:
1. Prompt(用户输入):用户问了什么
2. Completion(模型输出):模型答了什么
3. KV Cache(键值缓存):推理过程中的中间计算状态,长上下文场景下可能非常庞大

4. 日志与审计数据:合规要求下必须保留的调用记录
5. 评估与监控数据:用于质量追踪、A/B测试的标注和评分数据
6. Embedding向量:RAG架构下,知识库被切分、向量化后存储的密集向量
单看一次调用,这些数据微不足道。但乘以百万级、亿级的日调用量,事情就完全不同了。
一笔算给你看的账
我们不妨做一个粗略的估算。假设一家中型企业部署了内部AI助手,日均调用50万次,每次对话平均留下:
- Prompt + Completion:约 4KB
- 日志与审计元数据:约 2KB
- RAG向量(假设每次调用检索10个chunk,每个向量1536维float32,约6KB)+ 原始chunk文本
每次调用约产生 10-15KB 数据。日调用量50万次,就是 每天6-7GB的原始数据。看似不多?

但注意:KV Cache的持久化存储、多轮对话的完整上下文、评估系统的采样数据、以及合规要求的长期留存(金融行业往往要求保留7年以上),这些因素叠加后,数据量会以每年数TB甚至数十TB的速度增长。
更关键的是存储的隐性成本结构:
- 热存储(SSD/高性能对象存储):用于低延迟检索,单价高
- 温存储与冷存储:数据生命周期管理的复杂度本身也是人力成本
- 向量数据库的索引开销:HNSW等索引结构的内存与磁盘成本通常是原始向量的1.5-3倍
- 跨区域复制与备份:为容灾而生的冗余,直接让存储成本翻倍
MIT TR的报道核心观点正是:许多企业的AI ROI测算里,根本不存在“存储”这一行。 当AI应用规模化后,这笔账单才会突然出现在基础设施预算里,此时已骑虎难下。
技术侧:开发者能做什么
好消息是,这个问题在工程层面有解。核心思路是数据生命周期管理和分层存储策略。
下面是一个简化的数据分层处理示例,展示如何在推理管线中按数据类型分流存储:
from dataclasses import dataclass
from enum import Enum
from datetime import datetime, timedelta

class StorageTier(Enum):
    HOT = "hot"        # SSD, 低延迟, 高成本 - 用于活跃会话
    WARM = "warm"      # 对象存储, 中成本 - 30天内的审计与回溯
    COLD = "cold"      # 归档存储, 低成本 - 长期合规留存

@dataclass
class InferenceRecord:
    session_id: str
    prompt: str
    completion: str
    embeddings: list | None
    audit_metadata: dict
    created_at: datetime

def route_storage(record: InferenceRecord) -> dict:
    """根据数据类型与保留策略,路由到不同存储层"""
    retention_policies = {
        "conversation": timedelta(days=30),   # 对话内容: 30天后降级/删除
        "audit_log":    timedelta(days=2555), # 审计日志: 7年合规留存
        "embedding":    timedelta(days=90),   # 向量: 90天后可重建
        "kv_cache":     timedelta(hours=24),  # 缓存: 会话结束即清
    }

    plan = {
        "conversation": ("hot", "warm"),  # 先热后温
        "audit_log":    ("warm", "cold"), # 先温后冷
        "embedding":    ("hot", None),    # 到期直接删除, 可从原始数据重建
        "kv_cache":     ("hot", None),    # 纯临时数据
    }
    return {k: {"tiers": v, "ttl": retention_policies[k]}
            for k, v in plan.items()}

# 实际效果:企业可借此将长期存储成本压缩 60%-80%
# 关键洞察:embedding 不必永久保存 —— 存原始文本即可,向量可随时重新计算
这里最重要的一条工程原则是:向量是可重建的衍生数据,永远不要为它支付永久存储的溢价。 存原始文本,用批处理任务在需要时重建向量索引,往往比长期持有向量便宜得多。
决策侧:CFO和CTO应该问的三个问题
MIT TR这篇报道的价值,在于它把一个工程问题提升到了管理决策层面。如果你的公司正在规模化部署AI,以下三个问题值得在下次预算会上提出:
问题一:我们的推理数据留存策略是什么? 如果答案是“都存着,以后再说”,那基本可以断定存储成本已经失控或即将失控。必须明确:哪些数据为合规而存、哪些为模型改进而存、哪些纯属默认累积。 问题二:存储成本在AI单位经济(Unit Economics)中占比多少? 计算每次AI调用的全成本时,除了token费用和算力分摊,应把存储与数据管理成本分摊进去。很多团队发现,加上存储后,某些场景的ROI直接转负。 问题三:我们的供应商合同里,数据的存储和出口费用是怎么算的? 云厂商的对象存储、向量数据库服务、日志服务的定价模型各不相同,跨服务的数据流动(egress费用)常常是隐藏最深的坑。写在最后
AI产业有一个经典规律:每一代基础设施的瓶颈都会转移。 先是算力,然后是显存和带宽,现在轮到了数据存储。这不是存储本身变贵了,而是推理规模化后,“AI产生的数据”第一次成为企业基础设施预算中无法忽视的一行。
聪明的企业已经开始把“数据留存策略”当作AI架构设计的一等公民——就像十年前大家学会把“数据库设计”放在写代码之前一样。而反应慢的团队,则会在下一轮预算审核时,对着一份同比增长300%的存储账单陷入沉默。
成本优化没有银弹,但看不见的成本最贵。这份“隐性存储账单”,值得每一位决策者现在就翻开看看。